А ещё мы ищем в команду Monium разработчика системы логирования. Поэтому, если вы горите желанием делать масштабный продукт и у вас есть нужный опыт, то ждём ваш отклик.
Особенности наблюдаемости LLM-приложений и агентов
Даниэль Халиулин, технический менеджер Yandex Monium, рассказывает, в чём различия наблюдаемости ИИ-агентов и классических приложений, и какие новые observability-инструменты можно использовать уже сейчас.
20 августа 2026 г.
15 минут чтения
Всем привет, меня зовут Даниэль! К теме мониторинга я шёл постепенно — более 13 лет работал в разных ИТ-компаниях: техническим менеджером продукта, системным аналитиком, разработчиком, SRE и системным админом. В Яндексе с 2025 года занимаюсь продуктовым развитием главной системы мониторинга Monium.
Что общего у радиоактивности и ИИ-агентов
Наблюдая за развитием ИИ-агентов, я вспоминаю историю французского физика Анри Беккереля. В 1896 году в пасмурном Париже он ждал солнечного света, чтобы продолжить свои исследования фосфоресценции — явления, при котором энергия, поглощённая веществом, высвобождается в виде света.
Беккерель уже слышал о докладе Вильгельма Рентгена про загадочные X-лучи и нашёл связь между его и своими исследованиями. Логика экспериментов Беккереля была простой: он заворачивал фотопластину в чёрную бумагу и размещал сверху соль урана. Солнце «заряжает» эту соль, а та испускает лучи и засвечивает пластину. Но нехватка солнца мешала довести эксперимент до конца.
Однако 1 марта 1896 года Беккерель всё же решил проявить фотопластину, ожидая увидеть лишь бледные следы. Но следы оказались чёткими и яркими, хотя уран лежал в темноте и солнце на него не попадало. Так было положено начало открытию радиоактивности.
Какое отношение это имеет к нашим ИИ-агентам? Как известно, радиоактивность вызывает мутации (в тот момент, Беккерель, к сожалению, об этом не знал): бесконтрольный ИИ — тоже. Воздействие радиации можно отрицать, но оно происходит. Чтобы понять суть явления и принять меры, учёному тогда не хватало наблюдаемости и инструментов, ведь он имел дело с тем, с чем ещё не сталкивался. Точно так же и в ситуации с ИИ-агентами: они развиваются с большой скоростью, и нам нужно понять, как за ними наблюдать, на какие данные и в каких системах смотреть.
Можно сказать, нужен «счётчик Гейгера» для ИИ, который позволит выстроить систему мониторинга и детектировать сигналы о сбоях. Практические решения уже есть: в этой статье рассмотрим особенности мониторинга агентов, разберёмся в метриках оценки качества их работы и специальных observability-инструментах.
Что такое ИИ-агент
Для начала определимся с тем, что считать ИИ-агентами.
ИИ-агент — это приложение, в котором LLM автономно управляет циклом выполнения: воспринимает состояние среды, а также решает, какой инструмент вызвать следующим, и итеративно движется к цели без заранее прописанного сценария. В таком агенте LLM управляет всей логикой работы.
Соответственно, следующие решения, которые иногда называют агентами, ими не являются:
-
One-prompt-решения — это не агенты, а приложения, где с помощью интеграции LLM выполняется небольшая утилитарная задача: суммаризировать текст или классифицировать интенты.
-
Ещё один вид интеграции с LLM, который часто называют агентом, — workflow, жёстко заданный граф выполнения определённого процесса или автоматизация. В нём может быть один или несколько вызовов LLM, но суть в том, что разработчик заранее продумал основной flow.
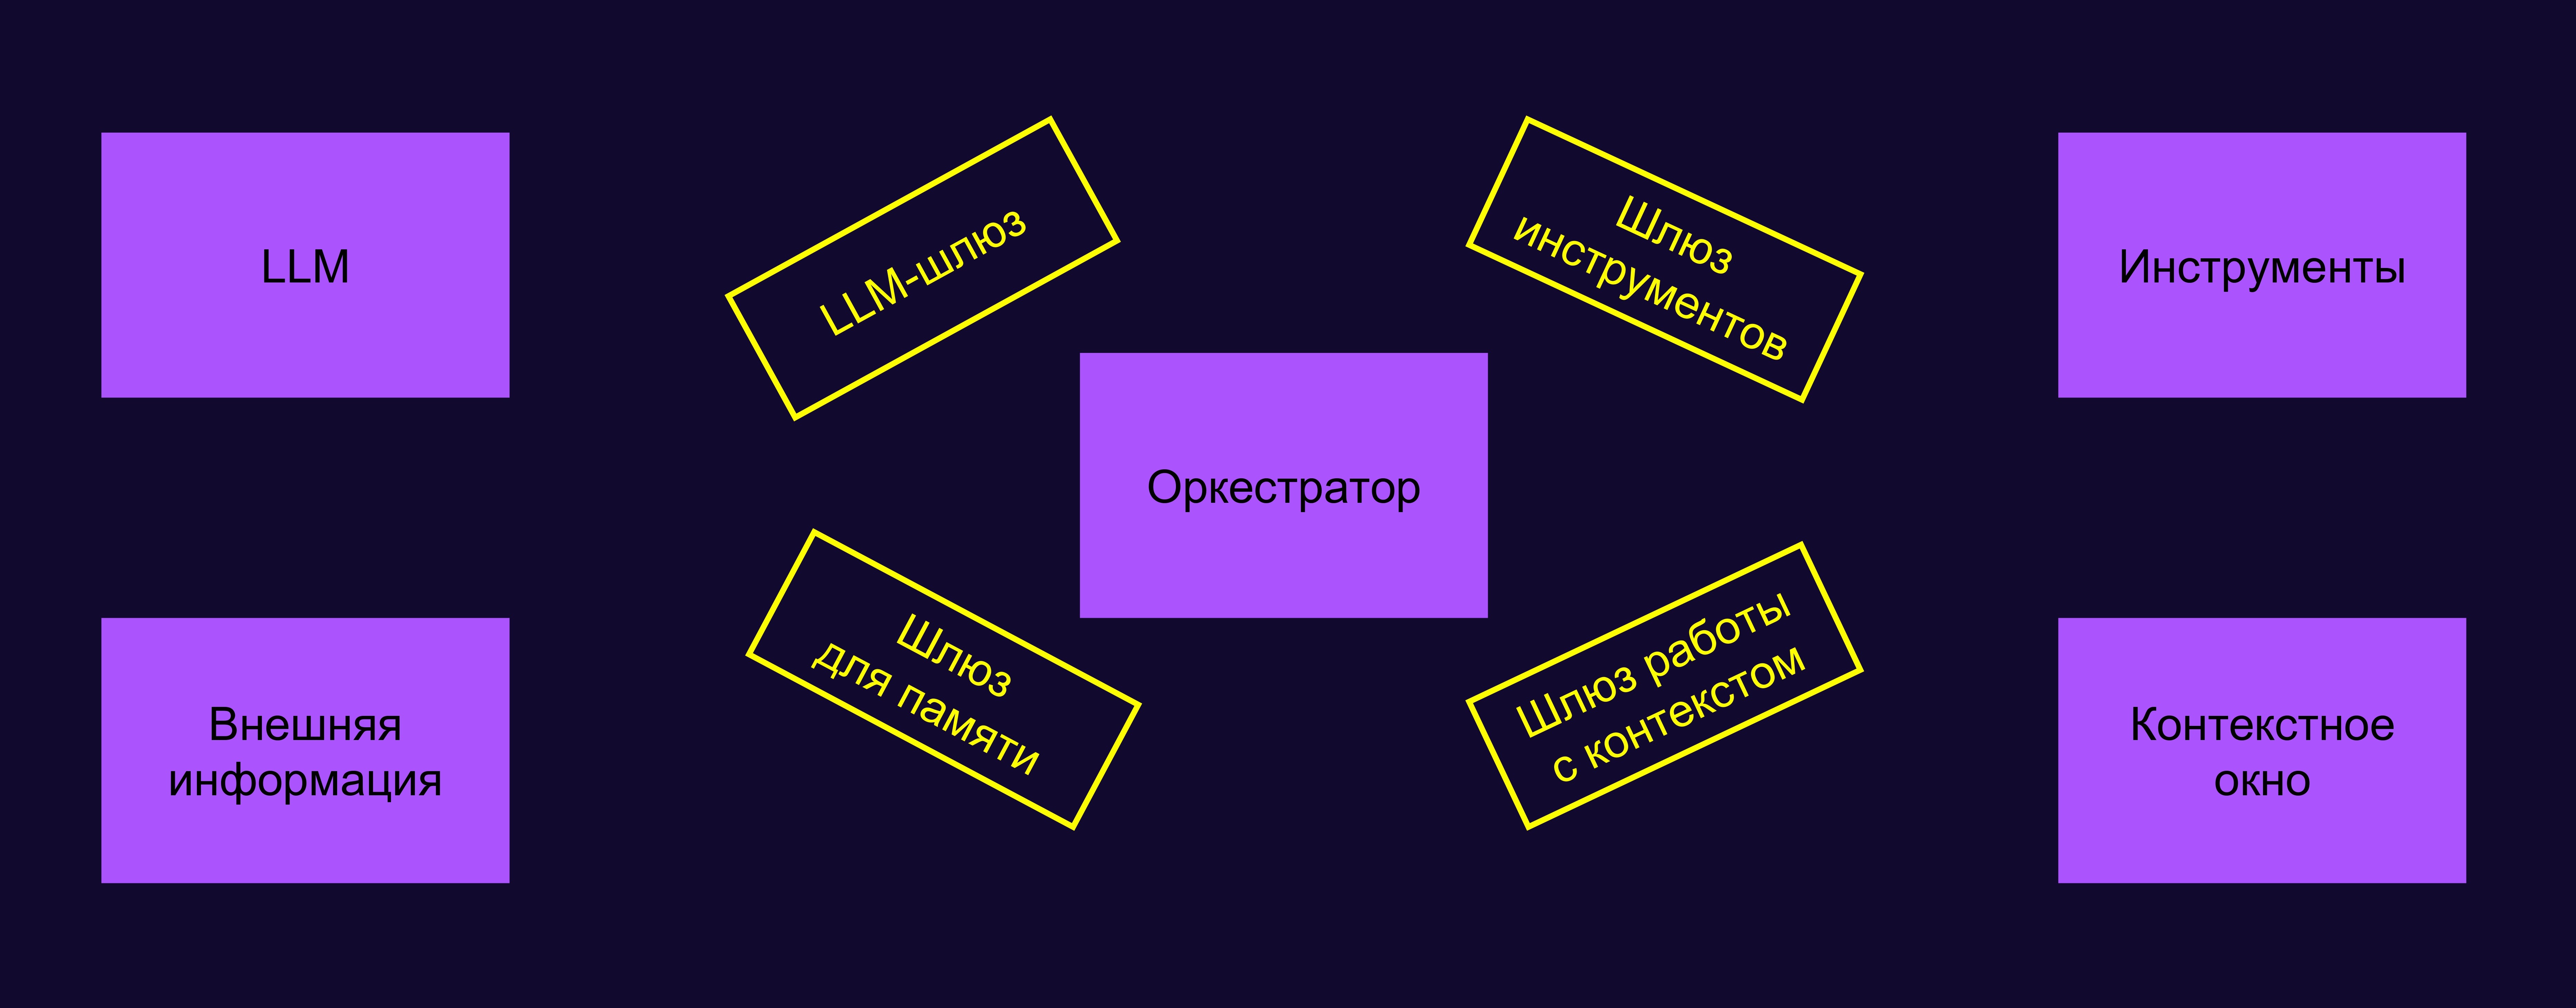
Логику работы ИИ-агента упрощённо можно представить так:
-
LLM — «мозг», управляющий ИИ-агентом.
-
Чтобы агент мог работать автономно и выполнять действия по запросу, нужен оркестратор — это логика, которая передаёт в модель данные, обрабатывает вывод.
-
Чтобы агент мог не только отвечать в чате, но и решать реальные задачи, ему нужны «руки» или инструменты. Например, внешние API, CLI, функции операционной системы.
-
Для решения конкретных задач агенту необходима релевантная внешняя информация: регламенты, корпоративная база знаний или другие данные по теме.
-
Также нужно контекстное окно — текущая «память» агента, то, что он знает в момент выполнения. Чем больше кормишь LLM информацией, тем хуже будет ответ, особенно если эта информация нерелевантная. Чем больше ненужной информации в контексте агента, тем выше риск галлюцинаций. Поэтому важна продуманная логика управления контекстом: помогут сжатие, суммаризация, приоритизация.
-
Для обеспечения отказоустойчивости, аналитики, мониторинга и других общих задач перед каждым «кубиком» нужны шлюзы. Они позволяют абстрагировать оркестратора от особенностей реализации частей агента.
Для построения всех этих систем и управления инфраструктурой не нужно быть большим специалистом по ML: важнее иметь навыки SRE или DevOps-инженера. Задач много: например, в каждом из шлюзов необходимы балансировка и лимитирование трафика. Или нужно настроить всё так, чтобы агент не заспамил шлюзы запросами и в то же время получал полезную информацию. А как сделать так, чтобы во внешнюю LLM не попадали секреты? Для решения подобных задач нужны опытные инженеры, и это тоже важно учитывать при создании системы мониторинга агентов.
Особенности наблюдаемости ИИ-агентов
Наблюдаемость ИИ-агентов — мера того, насколько хорошо мы понимаем внутреннее состояние агента по его внешним выходным данным. Чем лучше мы понимаем, что, как и почему сделал агент, тем выше мера этой наблюдаемости.
Когда мы говорим о мониторинге, то обычно вспоминаем RED-метрики, USE-метрики или Golden Signals. Но когда мы подходим к теме наблюдаемости ИИ-агентов, то понимаем, что традиционные подходы или не работают, или работают не так, как мы привыкли.
Можно выделить следующие особенности наблюдаемости ИИ-агентов:
Большие тексты — основная информация для анализа и отладки работы агентов
Теперь ключевые данные — это системные промпты, сообщения пользователя, ответы модели. Раньше мы имели дело с детерминированным кодом, который от запуска к запуску вёл себя одинаково. Мы всегда могли открыть код и по нему понять, как работает агент или приложение.
Как только в этой теме появились LLM, всё перестало быть таким очевидным: при каждом новом вызове LLM не всегда работает одинаково. Основная логика работы перестаёт управляться кодом, а количество сценариев, в которых может функционировать агент, — уже за пределами нашего понимания.
Если при разработке классических приложений мы дебажим их поведение по коду и понимаем, что происходит, то при создании ИИ-агентов мы дебажим поведение по контексту. Смотрим на то, какая информация была в конкретный момент у агента, что ему ответили инструменты, что было в системном промпте.
Например, агент может странно ответить клиенту, а по системному промпту такого ответа быть не должно. Однако анализ ответа тулов может показать, что один из ключевых тулов из-за внутренней ошибки ответил ему неверной информацией. Это и привело к тому, что агент сбился и тоже ответил неправильно.
Все эти ключевые тексты влияют на выполнение задачи. Если в привычной разработке код — основной источник правды, то теперь — это трейс.
Трейсы — ключевой сигнал для анализа поведения агентов
Именно в трейсе находится та информация, которая повлияла на логику работы агента в тот или иной момент. По коду восстановить поведение агента уже нельзя (не понимая его контекста, который хранится в трейсе).
Однако сначала казалось, что именно логи для этих целей подходят больше. Но если в них писать промпты, ответы модели и инструментов, входные параметры, то они превратятся в массу огромных JSON, которую при сбое оперативно проанализировать нереально.
Кроме того, агенты обычно пишет одна команда, бэкенды — другая, а значит, логи могут лежать в разных местах. При инциденте инженеру придётся тратить время на то, чтобы узнать, где находятся логи, точно ли они есть, да ещё и доступы проверять.
Почему же трейсы подходят больше?
- Данные удобно отображаются как диаграмма Ганта или в виде дерева: это помогает сразу понять происходящее с агентом.
- Контекстность — в спанах есть атрибуты с контекстом того или иного момента выполнения.
- Распределённость — трейсы обычно by design хранятся в единой системе, что удобно для быстрого поиска причин сбоя и отладки.
Однако как бы ни были хороши трейсы, без метрик никуда. Но с ними не всё так просто. Отсюда — третья особенность.
Метрики стало оценивать сложнее
Рассмотрим несколько видов метрик, которые можно использовать при оценке ИИ-агентов.
Инфраструктурные метрики
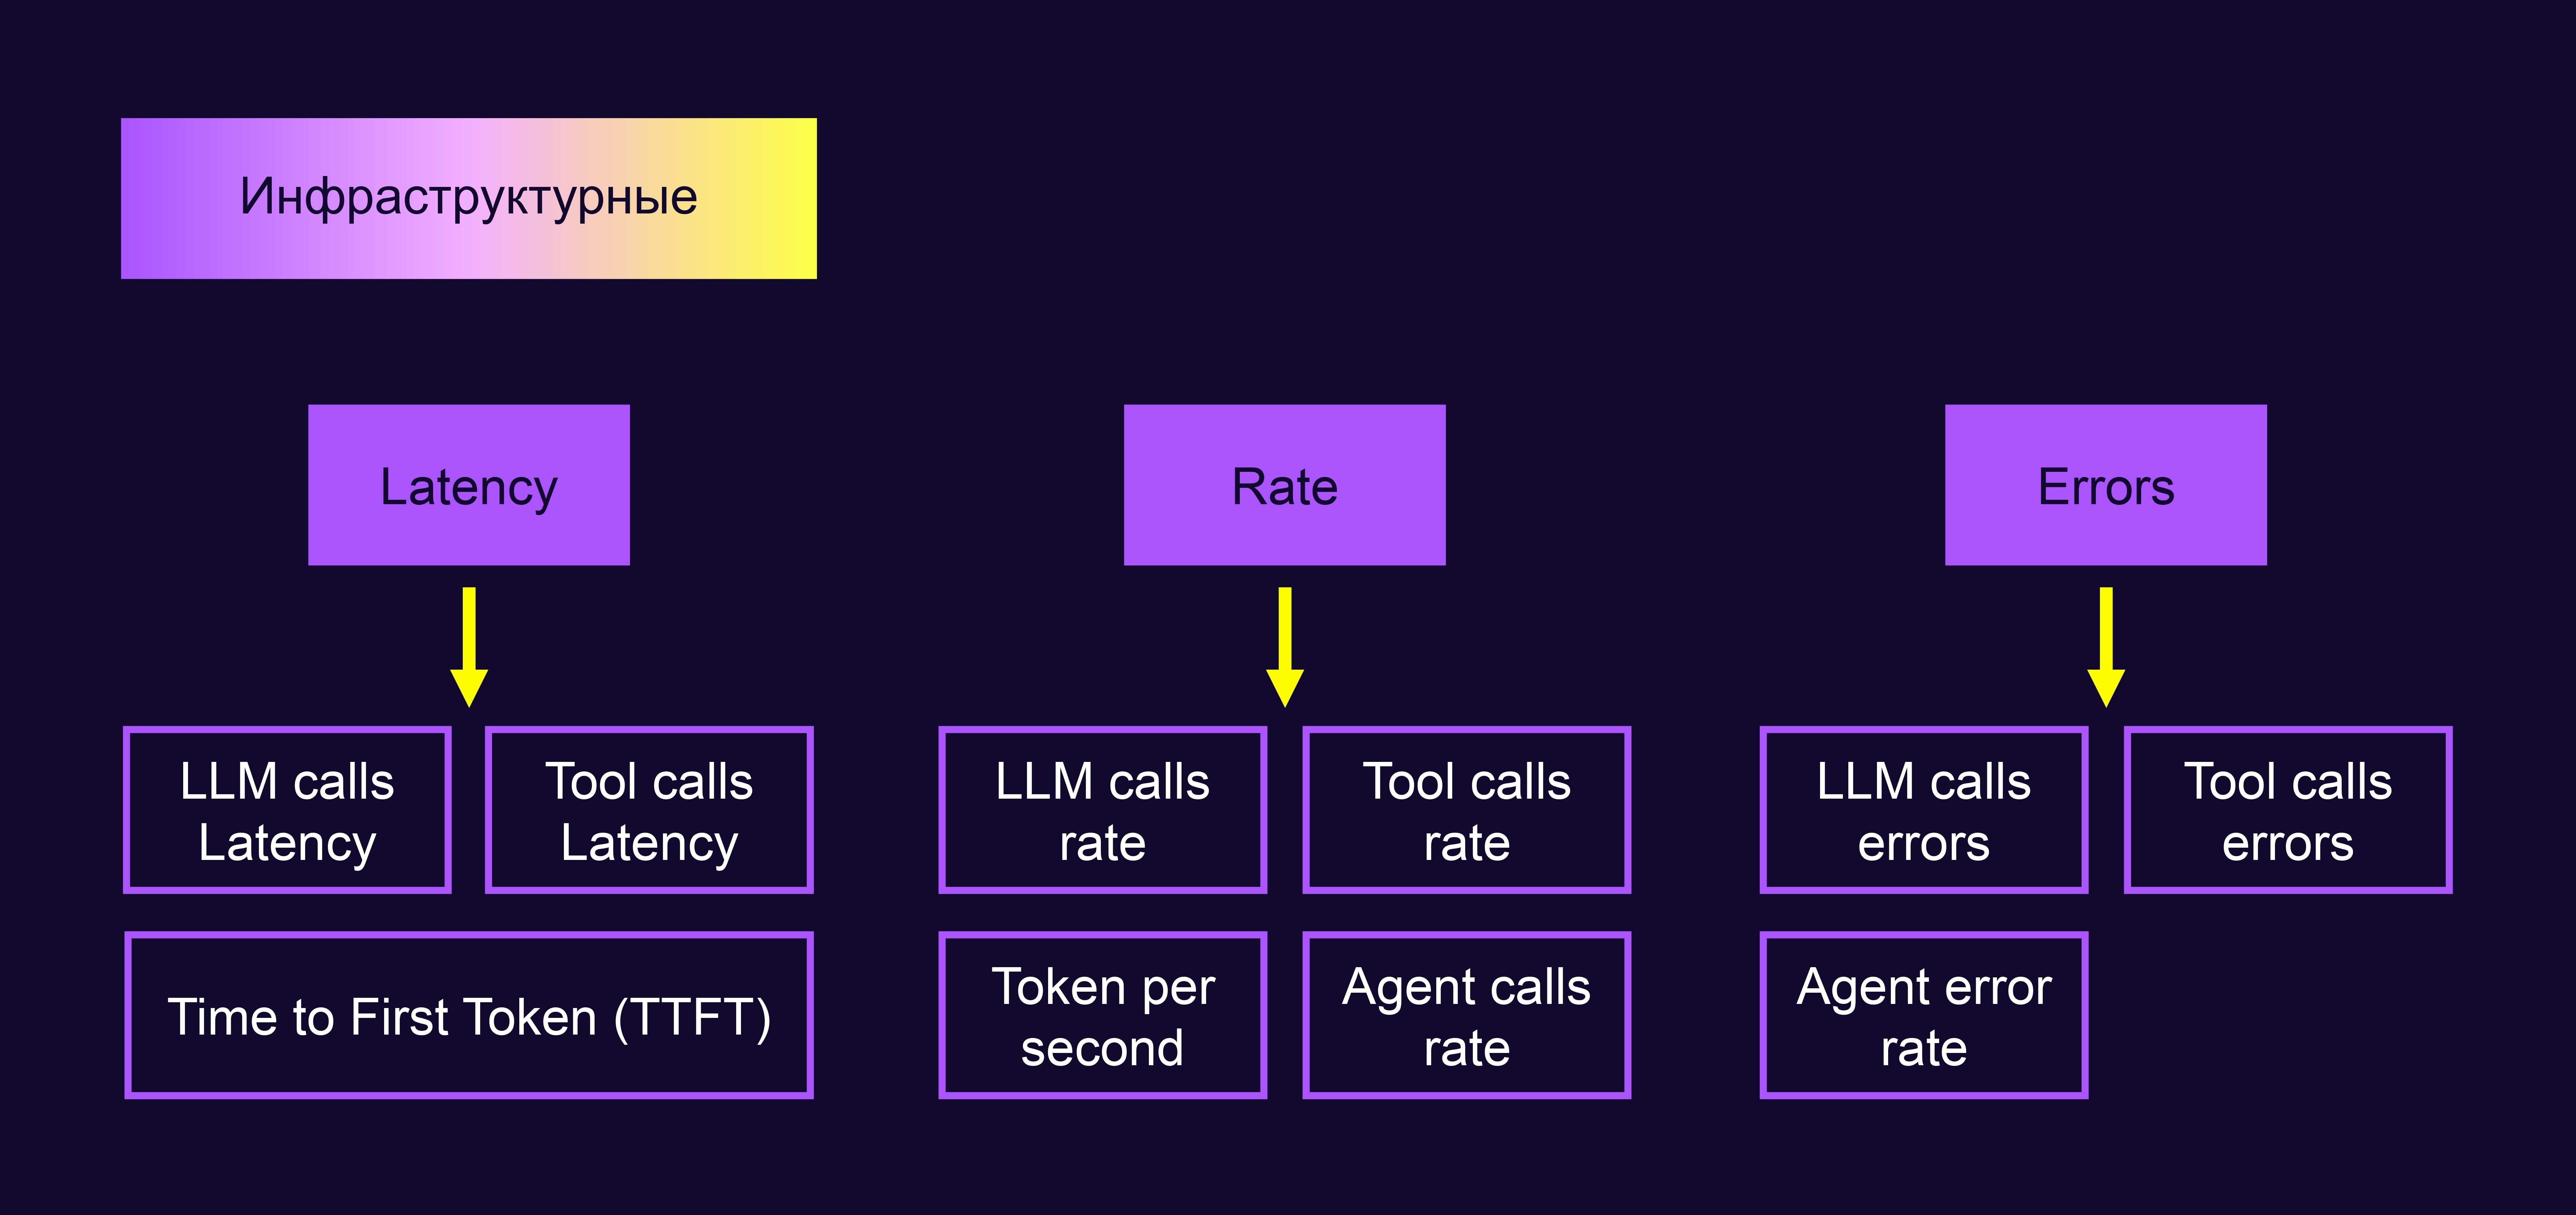
К таким метрикам относятся: задержка ответа модели и инструментов, число вызовов модели и инструментов, время от запроса до первого токена ответа, расход токенов и другие.
Они позволяют понять, насколько хорошо работает инфраструктура под агентом. Например, метрика Time to First Token — время от запроса пользователя до первого токена, который ему отдаст модель, — говорит о воспринимаемой производительности. Чем она меньше, тем нам как пользователям кажется, что процесс идёт быстрее.
Здесь же — метрики по ошибкам: когда модель не ответила в заданное время, инструменты ответили с ошибкой или агент дал сбой.
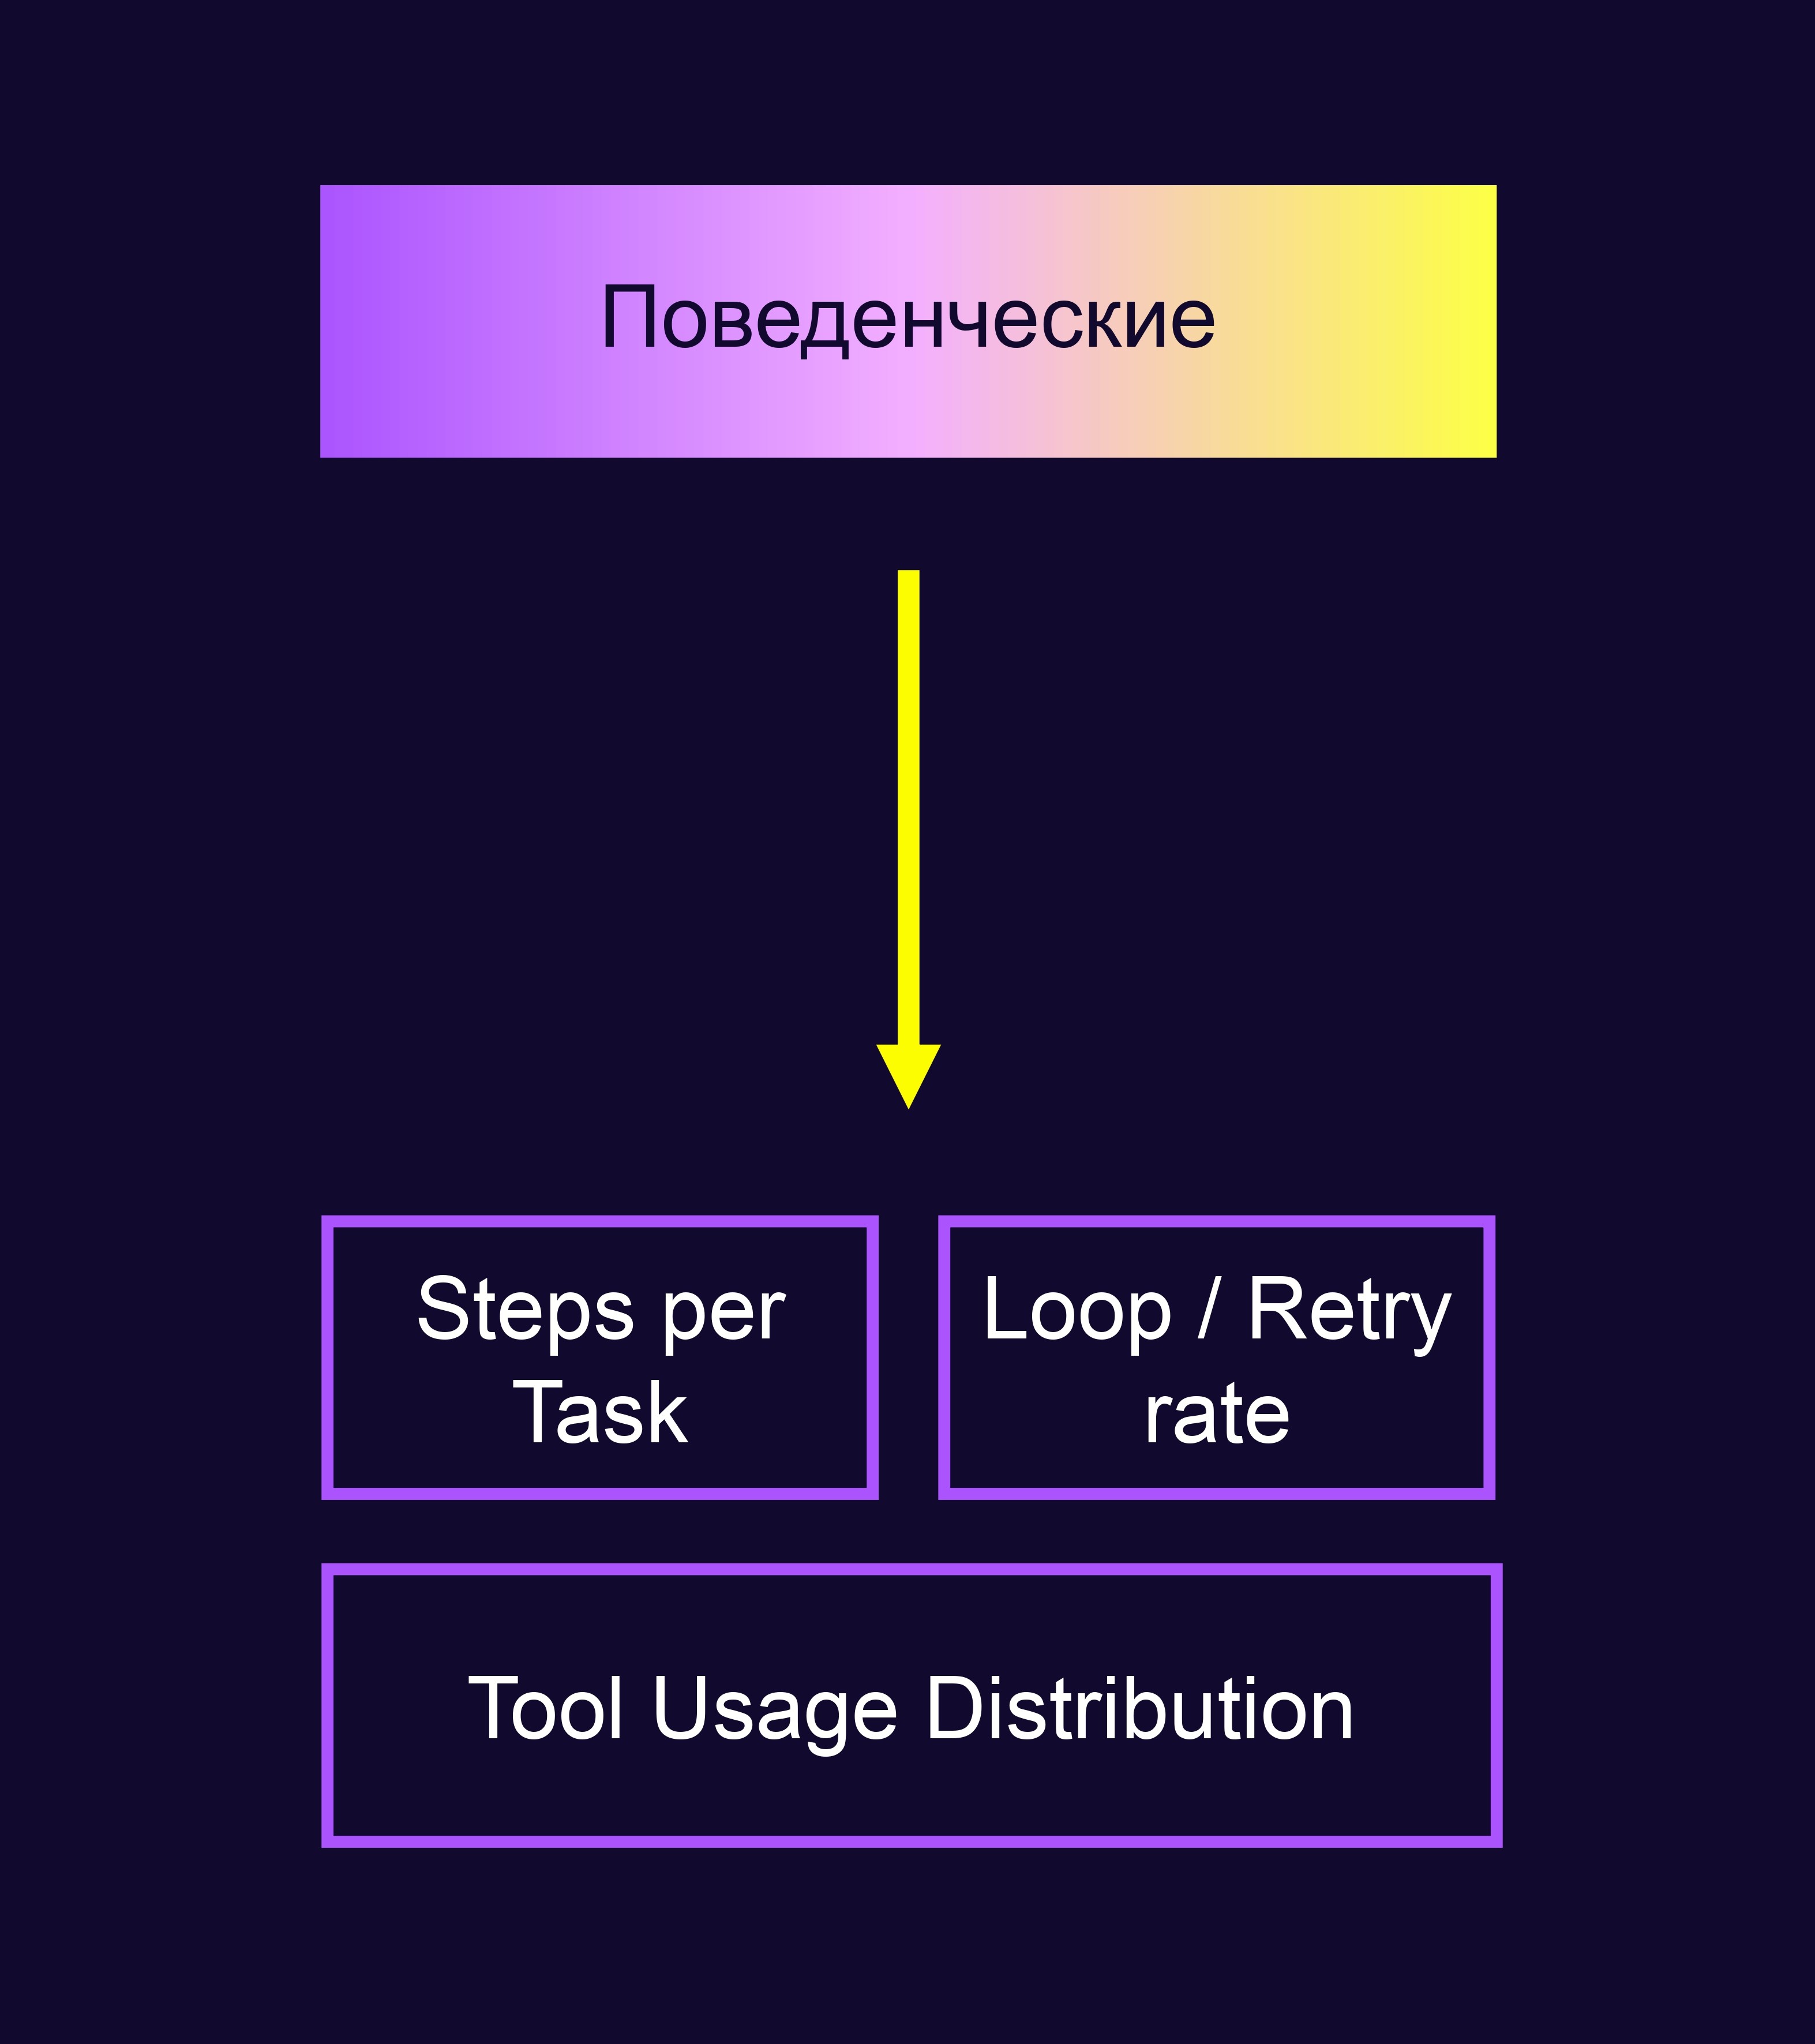
Поведенческие метрики
Они говорят о поведении агента, например, о количестве шагов, которые он обычно выполняет для решения задачи, о частоте попадания в определённый цикл или распределении вызовов инструментов.
Экономические метрики
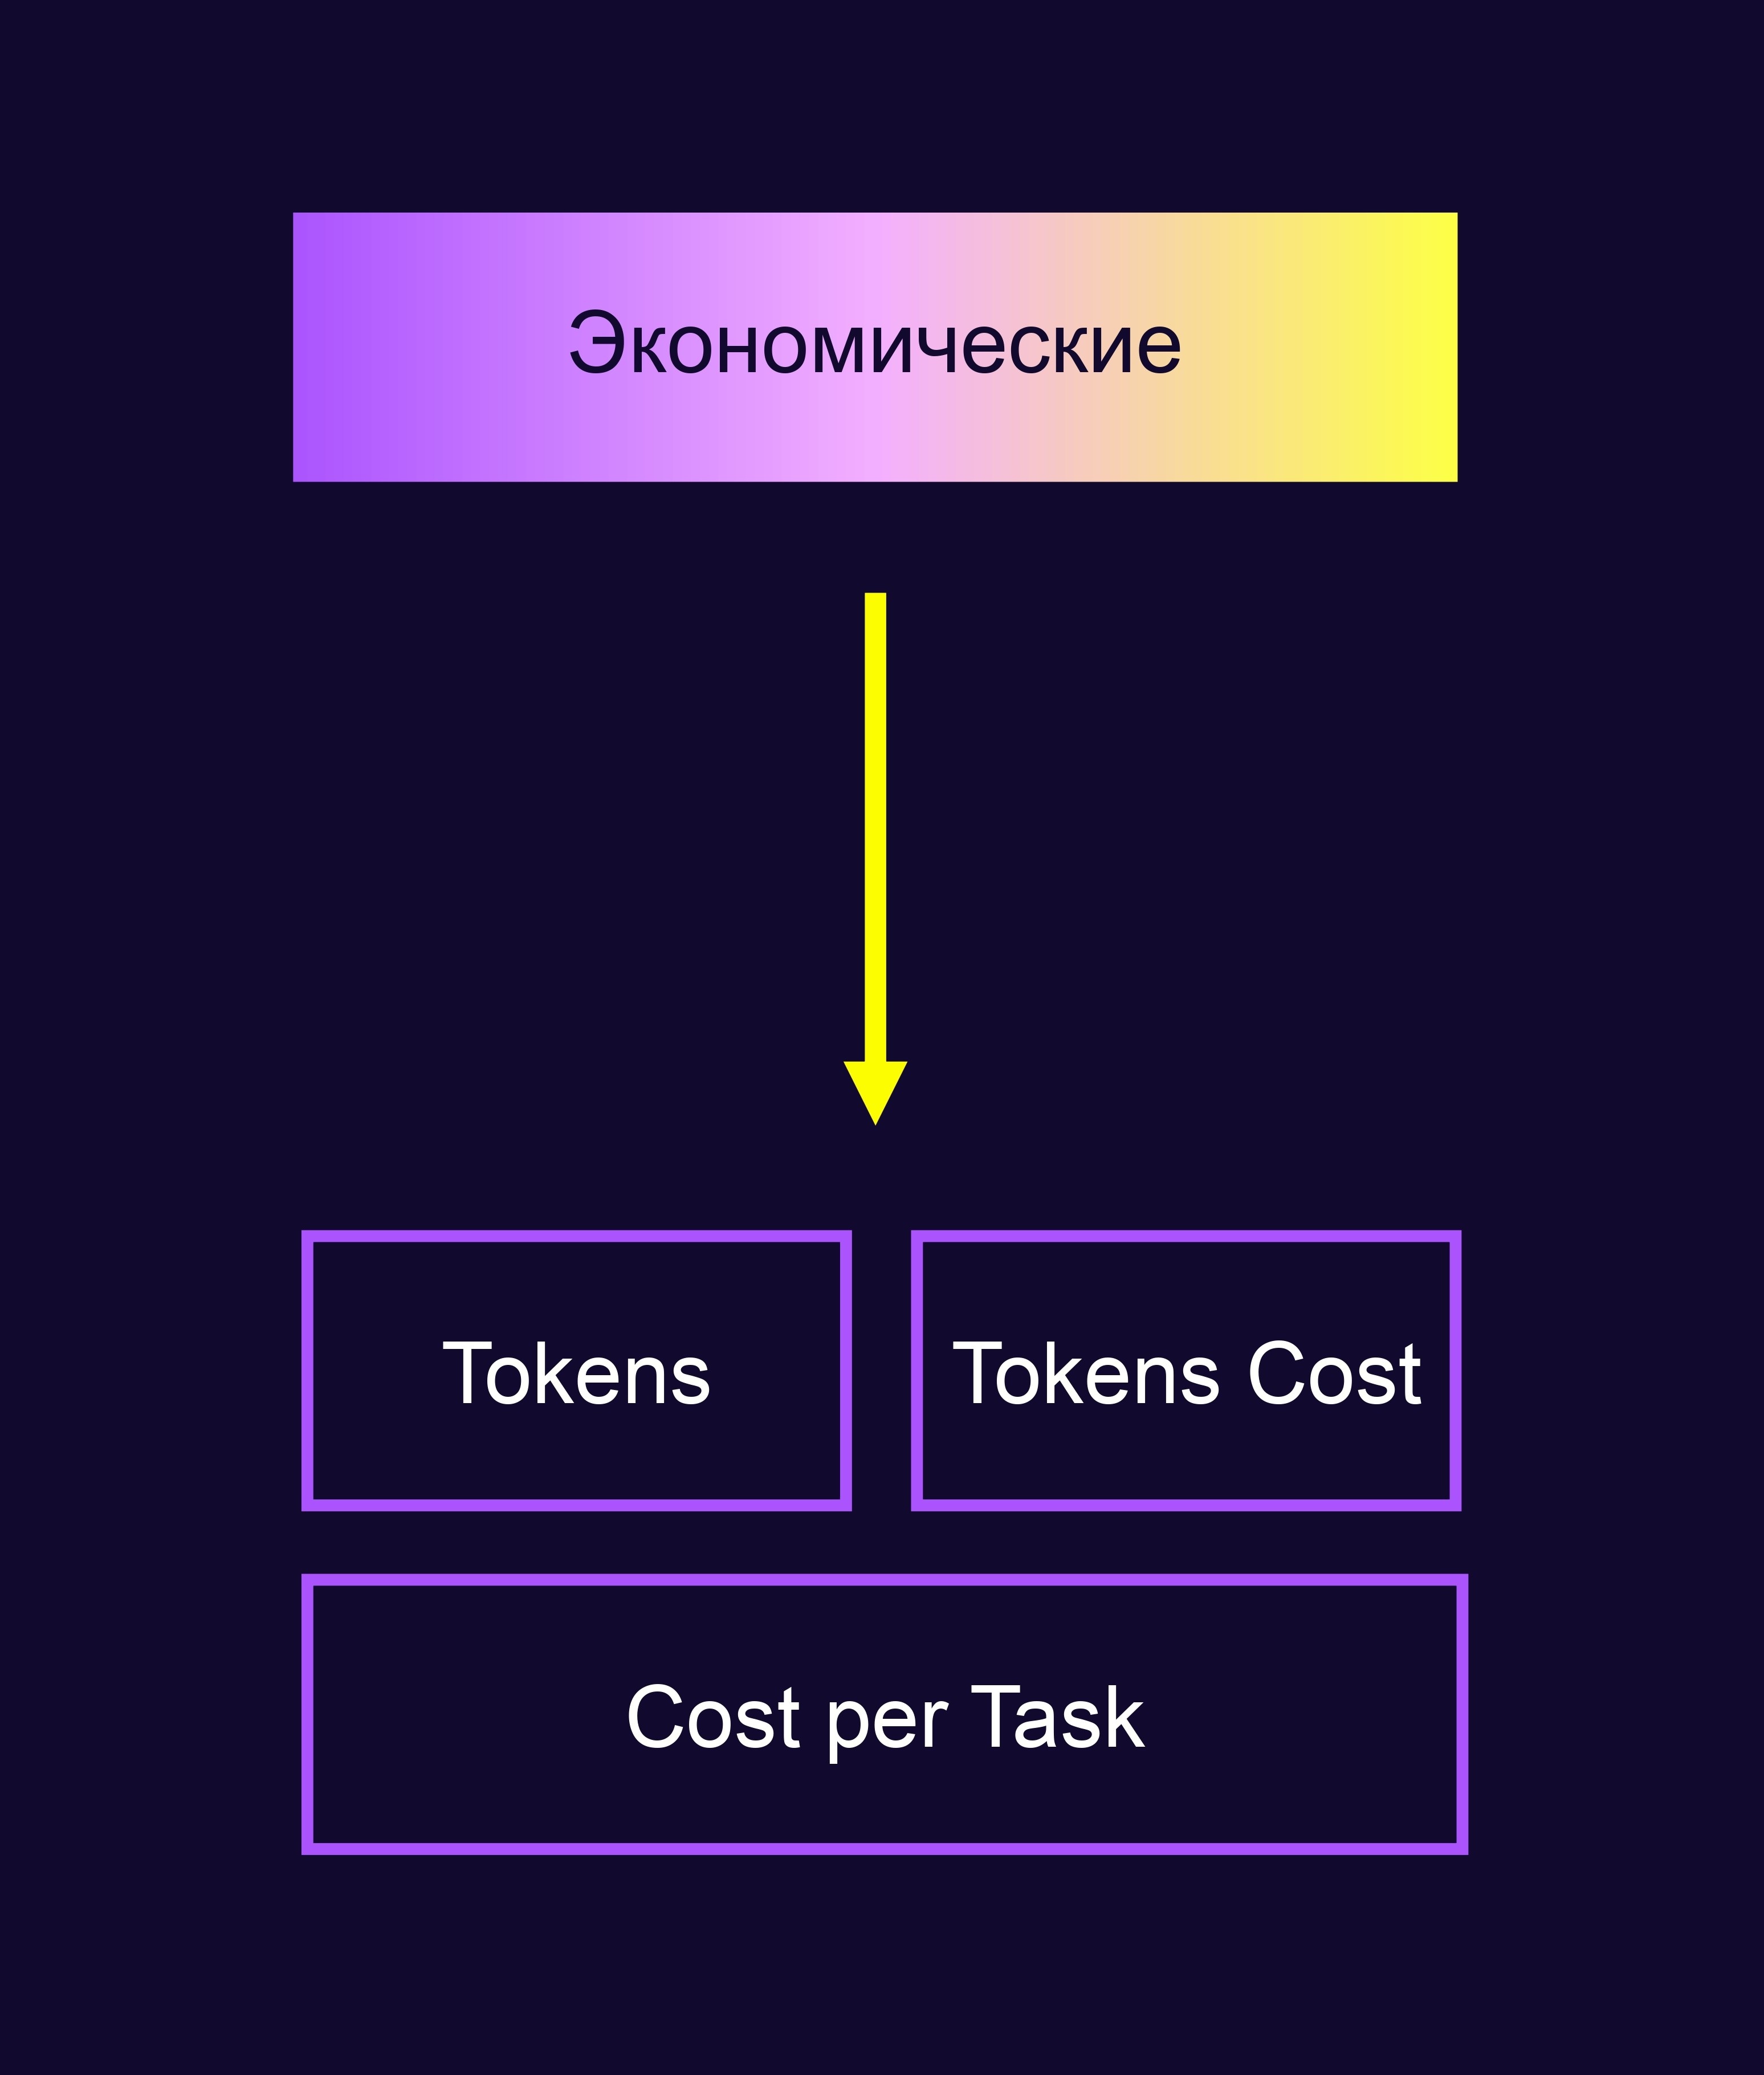
С помощью этих метрик можно померить токены, расход входящих и исходящих токенов, стоимость в токенах на задачу, которую выполняет агент.
Конечно, это не весь список метрик, а то, с чего можно начать. Однако при работе с метриками стоит учитывать следующие сложности:
-
Во-первых, некоторые метрики могут отображать разные показатели в зависимости от типа решаемой задачи. Для одной задачи агенту нужно сделать 5 шагов, для другой — 25 шагов. Если замерять всё это вместе, то метрики будут показывать ерунду.
Решение — выделение во всех метриках агента некоторой «корзины» для описания типа задачи. Тогда можно анализировать метрики по конкретному виду задач или уровню их сложности.
-
Во-вторых, природа ошибок стала семантической. Ошибка перестала быть бинарной (упало/не упало). Появился спектр: ответ может быть неточным, токсичным, многословным или слишком коротким. По всем базовым метрикам всё может быть чётко: агент работает быстро, без ошибок. При этом он может совершенно не выполнять изначальную задачу или отвечать пользователям быстро, но полную ерунду.
Мы приходим к тому, что оценку качества работы агентов нужно делать по-другому.
Новые подходы к оценке
Чтобы понять, как менять подход, вспомним системы оценки качества в классических приложениях, не агентах. Сначала пишем детерминированную логику, затем — тесты (ручные или автотесты), которые позволяют проверить, что всё делается верно. Кто-то делает наоборот, но сути это не меняет. И на третьем этапе выполняем тесты регулярно, чтобы убедиться: наши изменения ничего не сломали.
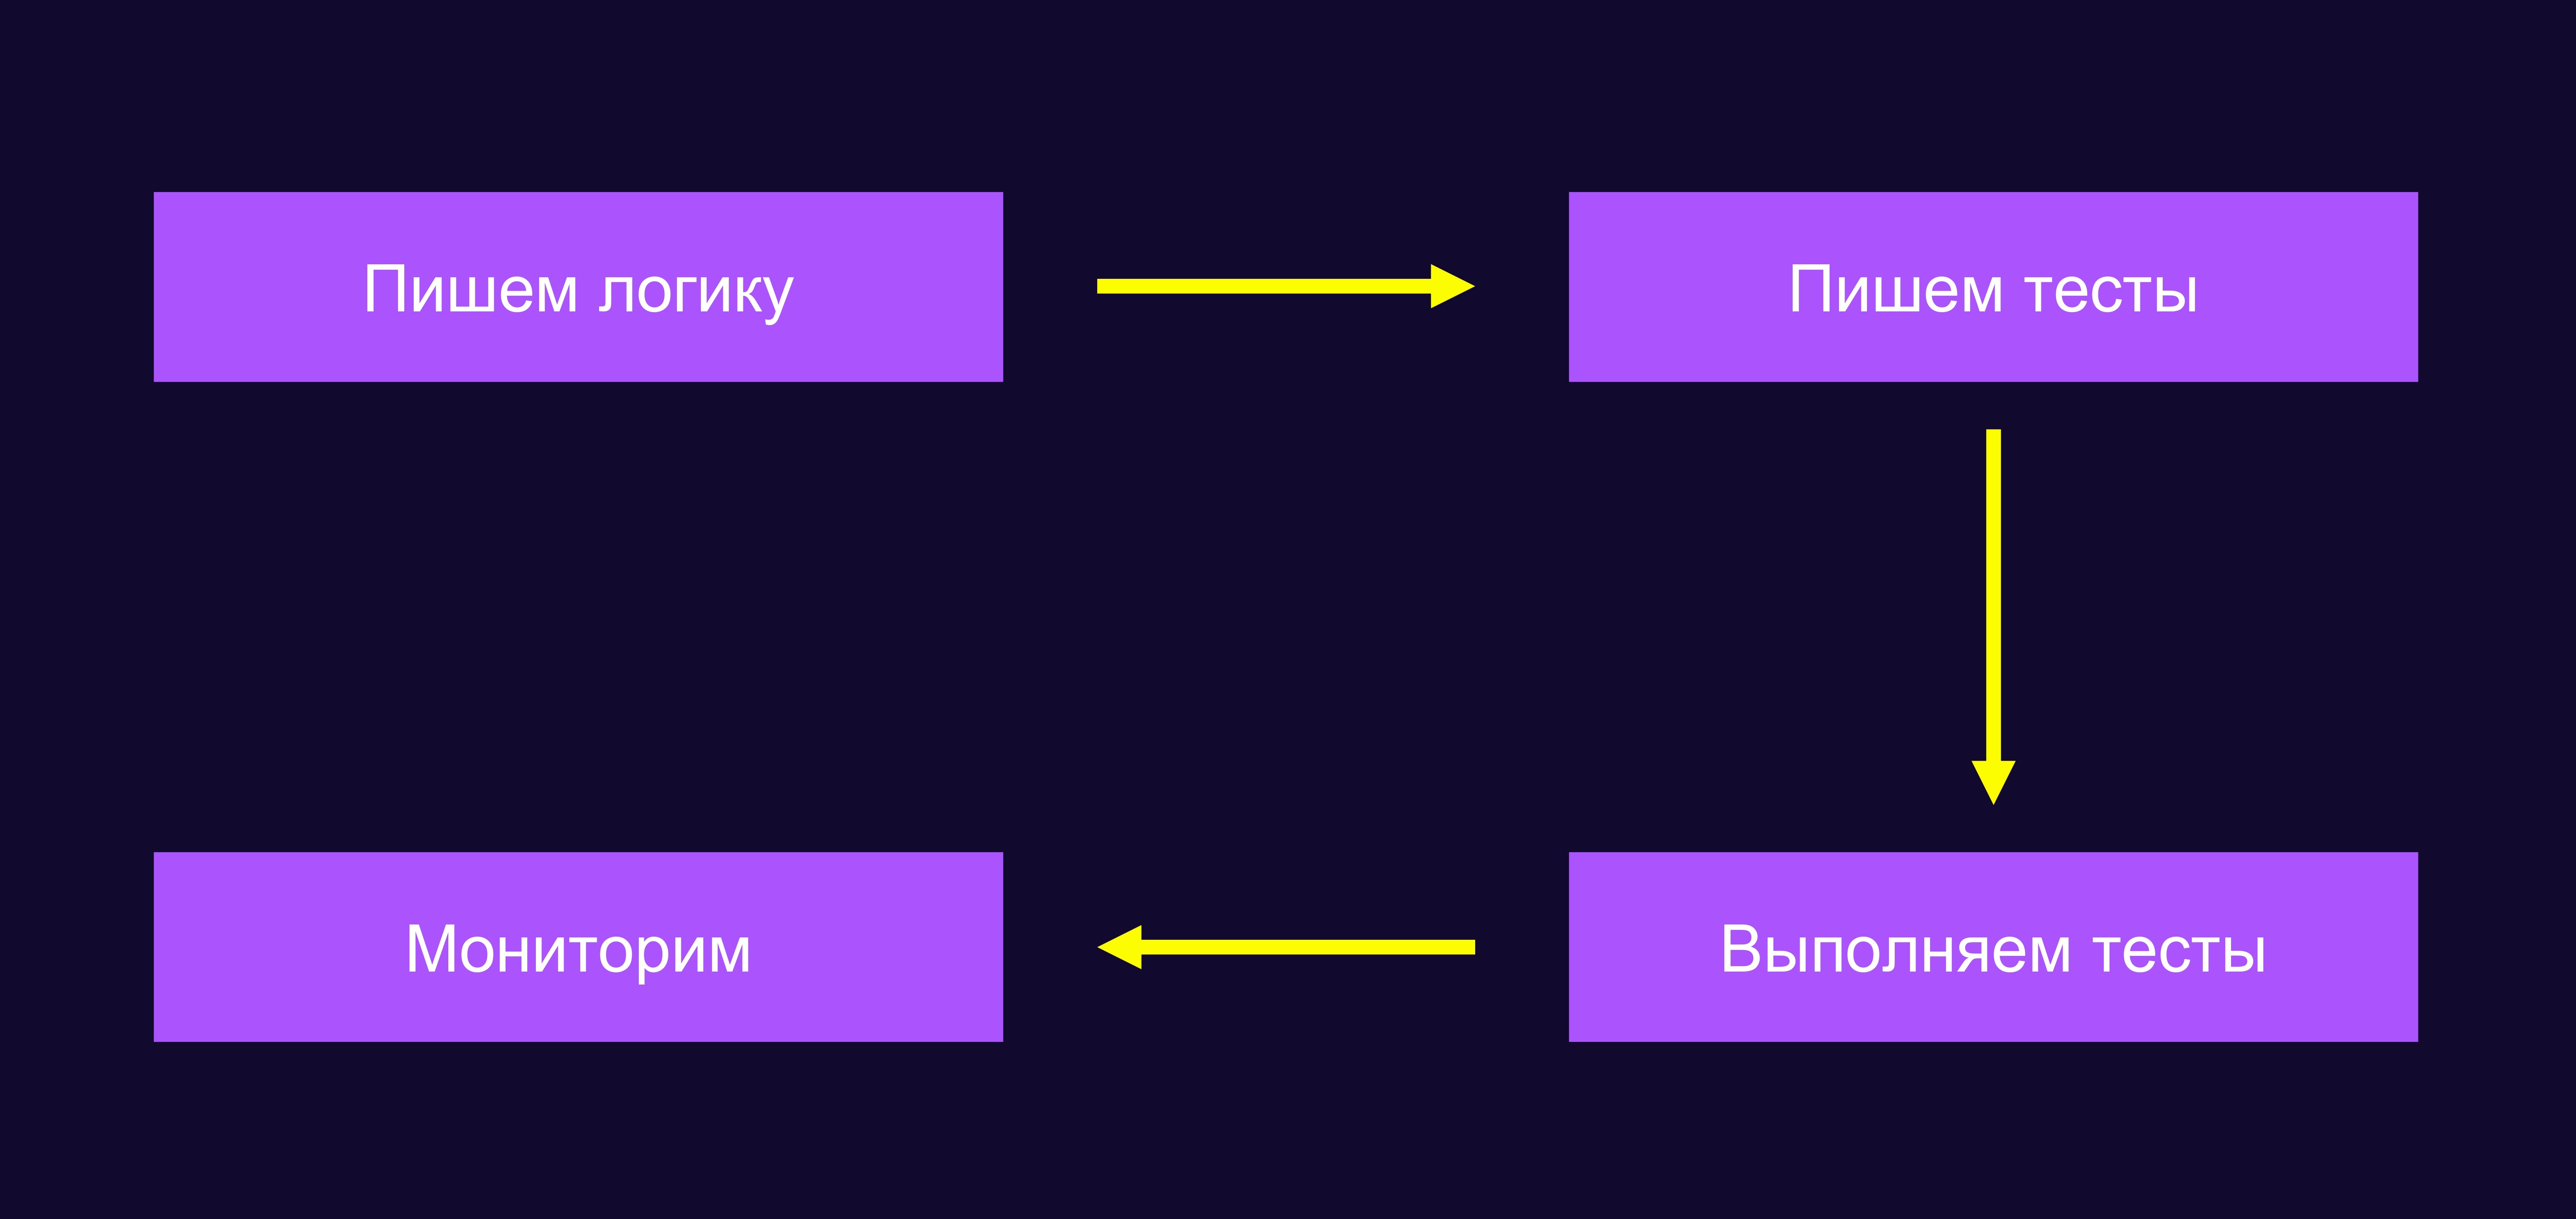
Ключевой момент: когда написанный код детерминирован, даёт предсказуемый результат, проверен на этапе разработки и не содержит непроверенных изменений, то обычно мы считаем: достаточно мониторить инфраструктуру под этим кодом и базовые метрики производительности для конкретного приложения.
При оценке работы агентов этот подход ломается:
-
логика становится недетерминированной — теперь ей управляет модель в самом агенте, поэтому от запуска к запуску агент может работать по-разному;
-
агенты ломаются тихо и уверенно — тихо, потому что инфраструктурные метрики могут показывать, что всё хорошо, а уверенно, потому что при всём этом агент может без тени сомнений говорить совсем не то.
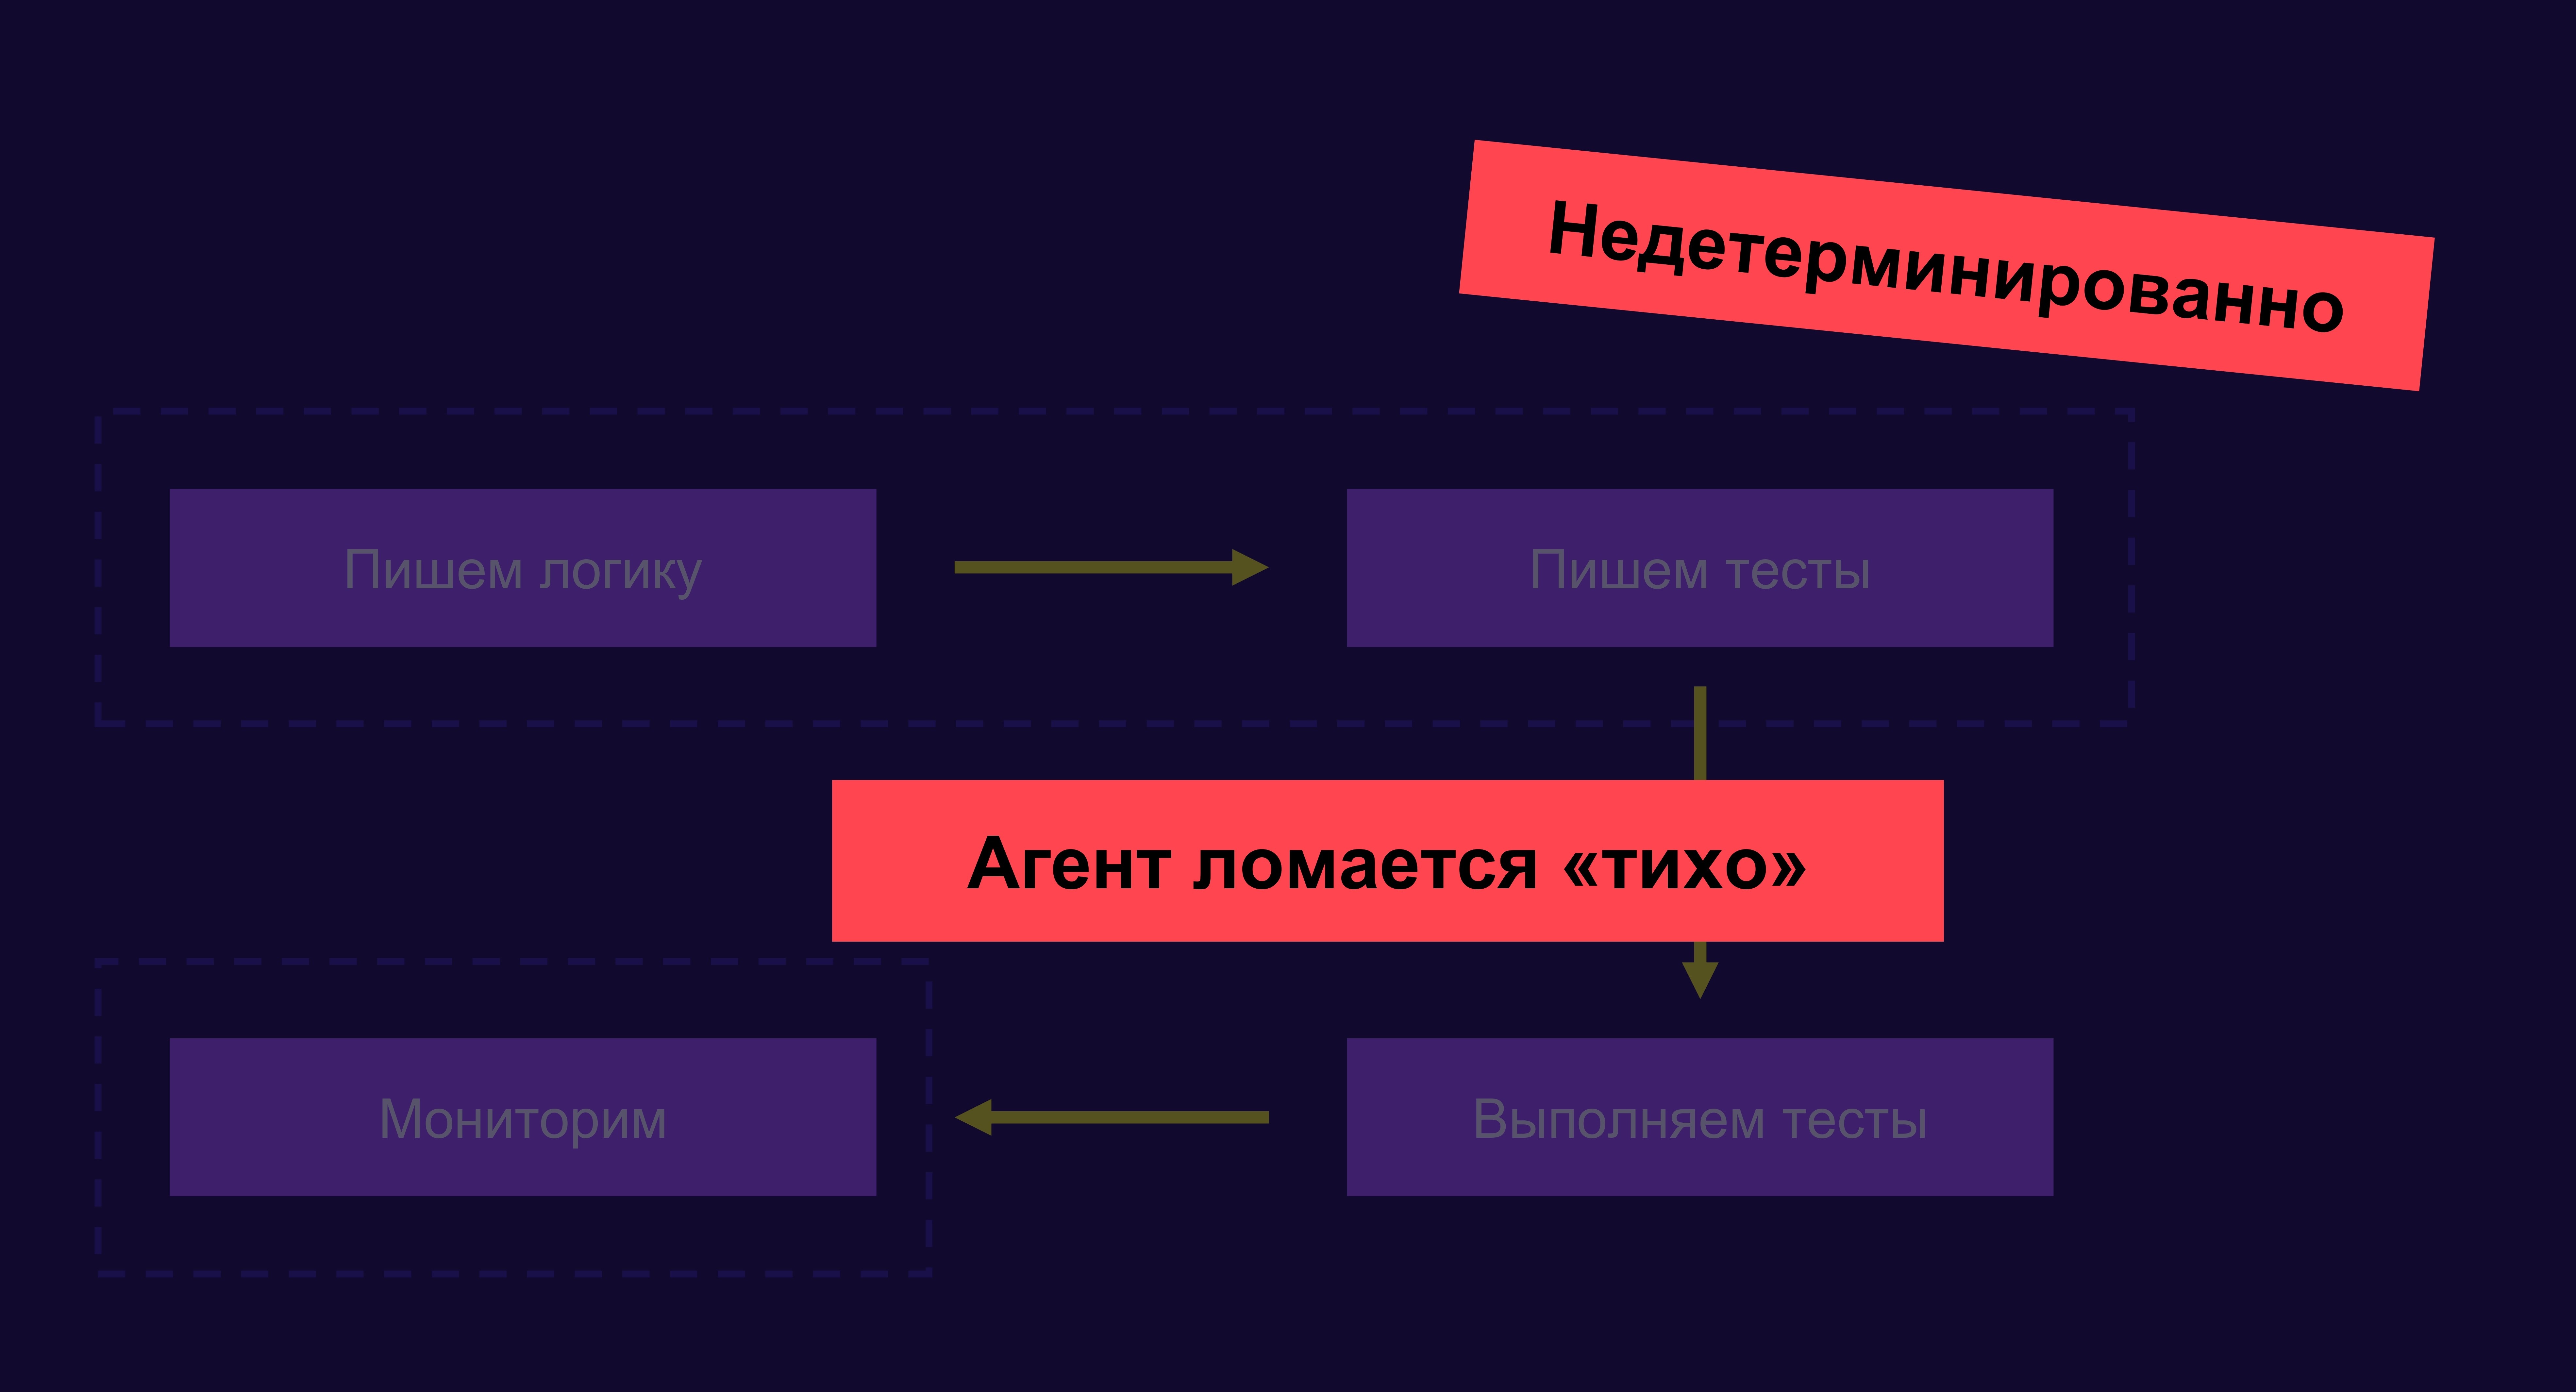
Как такое вообще можно мониторить?
Меняем подход: эвалы
На помощь приходит новый подход к наблюдаемости работы ИИ-агентов — evaluations или эвалы.
Эвалы помогают оценить качество работы ИИ-агента, смысл его ответов и корректность действий. Если в классическом мониторинге мы больше оцениваем сигналы вокруг приложения и не читаем каждый JSON, то в случае с эвалами мы оцениваем тот самый контент ответа агента.
Можно использовать как офлайн-, так и онлайн-эвалы.
Офлайн-эвалы
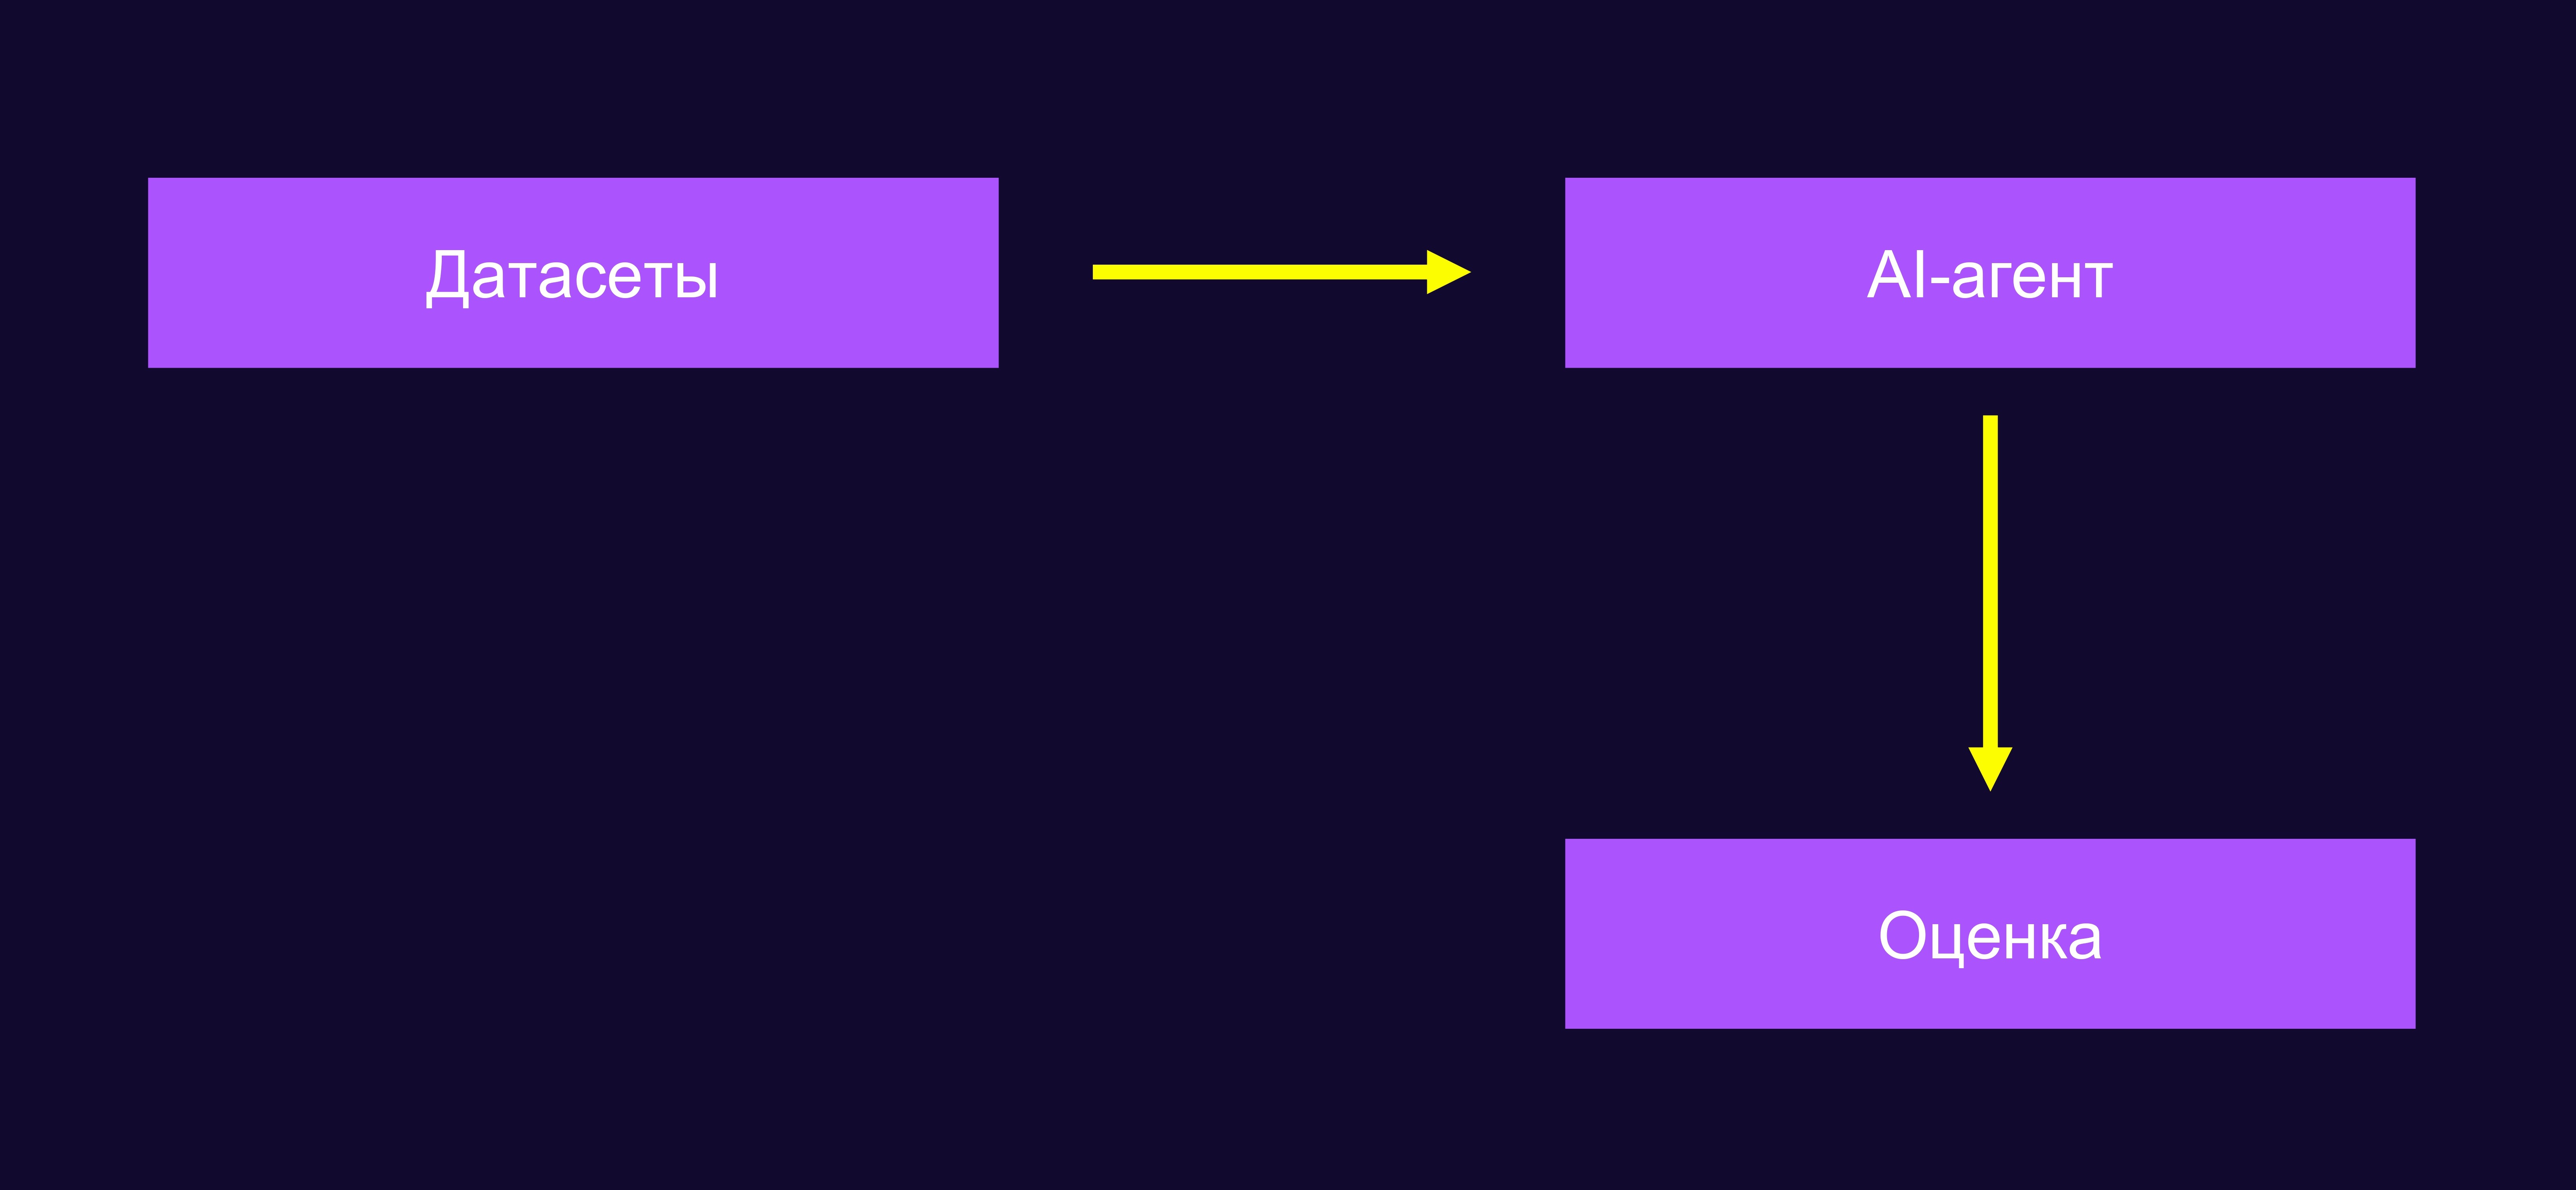
Оценка качества работы агента выполняется по заранее подготовленному датасету, который не меняется онлайн. В этих датасетах есть запрос пользователя и его ожидаемый ответ. На этапе разработки очередной версии ИИ-агента такие датасеты автоматически прогоняются через агента, и результат сохраняется. Далее выполняется оценка работы агента автоматизированным способом: сравнение ожидаемого и фактического.
Можно, например, проверить, дал ли агент ответ на языке пользователя, использовал ли агент верные инструменты для конкретного типа задачи.
Но проверки можно делать не только на этапе разработки.
Онлайн-эвалы
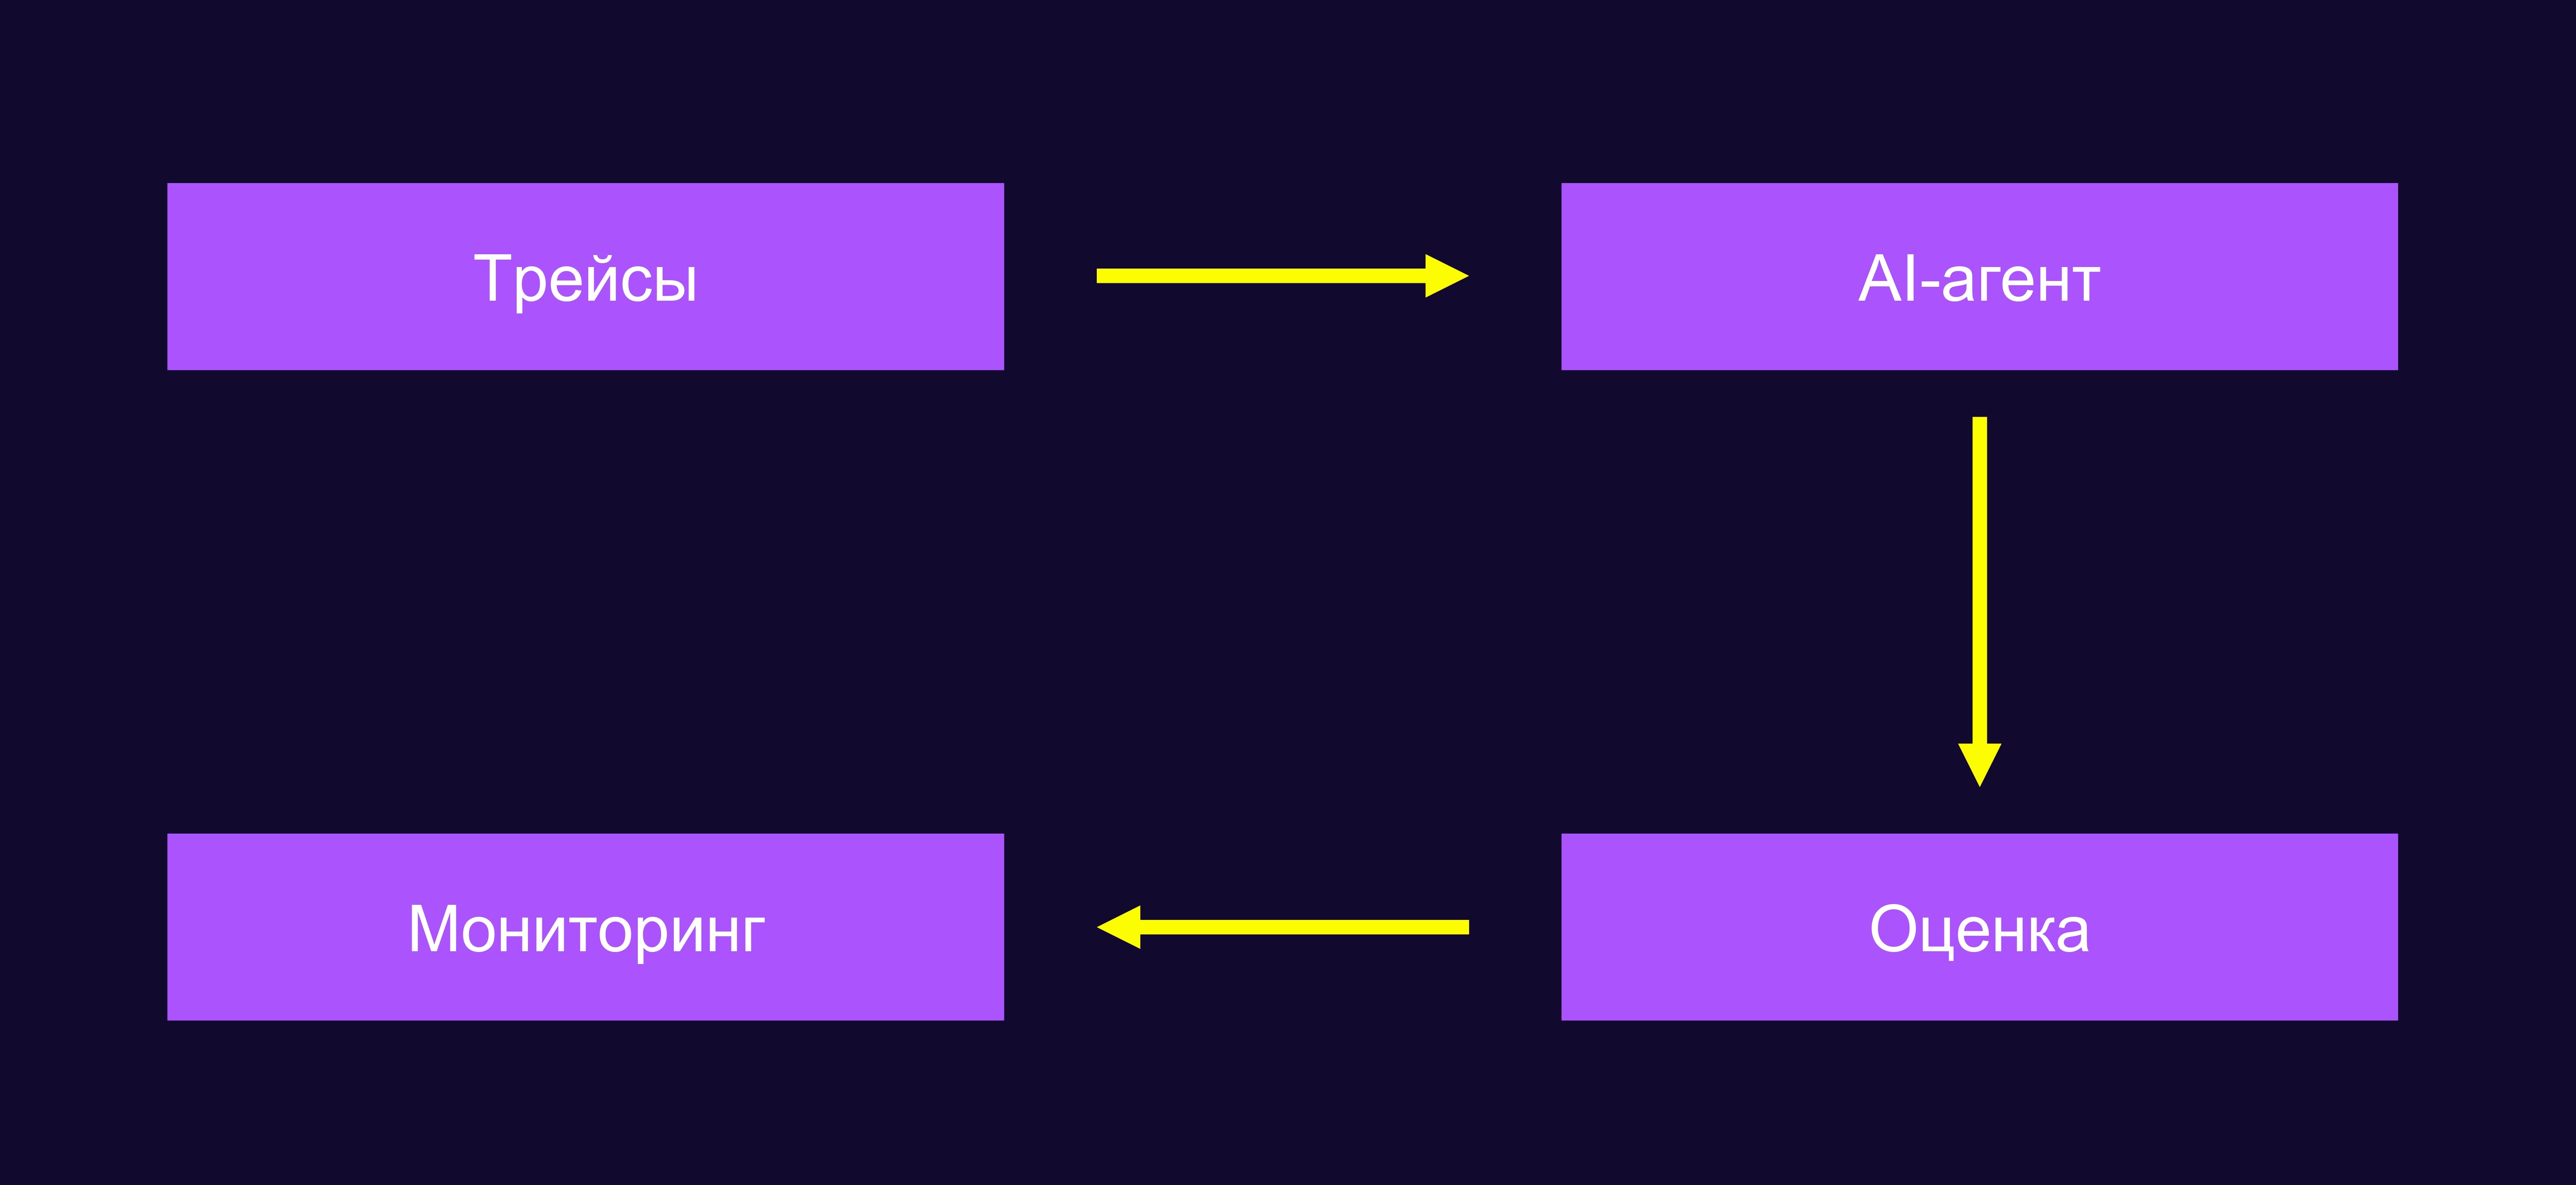
Для оценки качества работы в продакшене уже используется такой подход, который вместо стабильных датасетов задействует онлайн-набор данных. Агент работает, мы у него забираем часть трейсов, которые он создаёт прямо в процессе работы, и по ним запускаем проверки. Это позволяет делать онлайн-мониторинг и реагировать на метрики качества агента.
Если регулярно оценивать агента с помощью эвалов, то можно вписать метрики с результатами в систему мониторинга и повесить на неё алерты. Например, настроить алерты на статистически значимое проседание метрик качества. Даже если инфраструктура будет чувствовать себя прекрасно, но агент поведёт себя не так, мы быстро об этом узнаем.
Подход хорош, но для ручных проверок объём данных велик. Можно, конечно, нанять разметчиков для оценки, но в индустрии есть другой подход — так называемый LLM as a Judge: на трейсы и логи агента запускается LLM, которая выполняет оценку качества работы агента по прописанным промптам оценки. Каждая такая проверка может выставлять свою оценку.
Практические инструменты для мониторинга агентов
Что можно сделать для мониторинга работы ваших ИИ-агентов уже завтра?
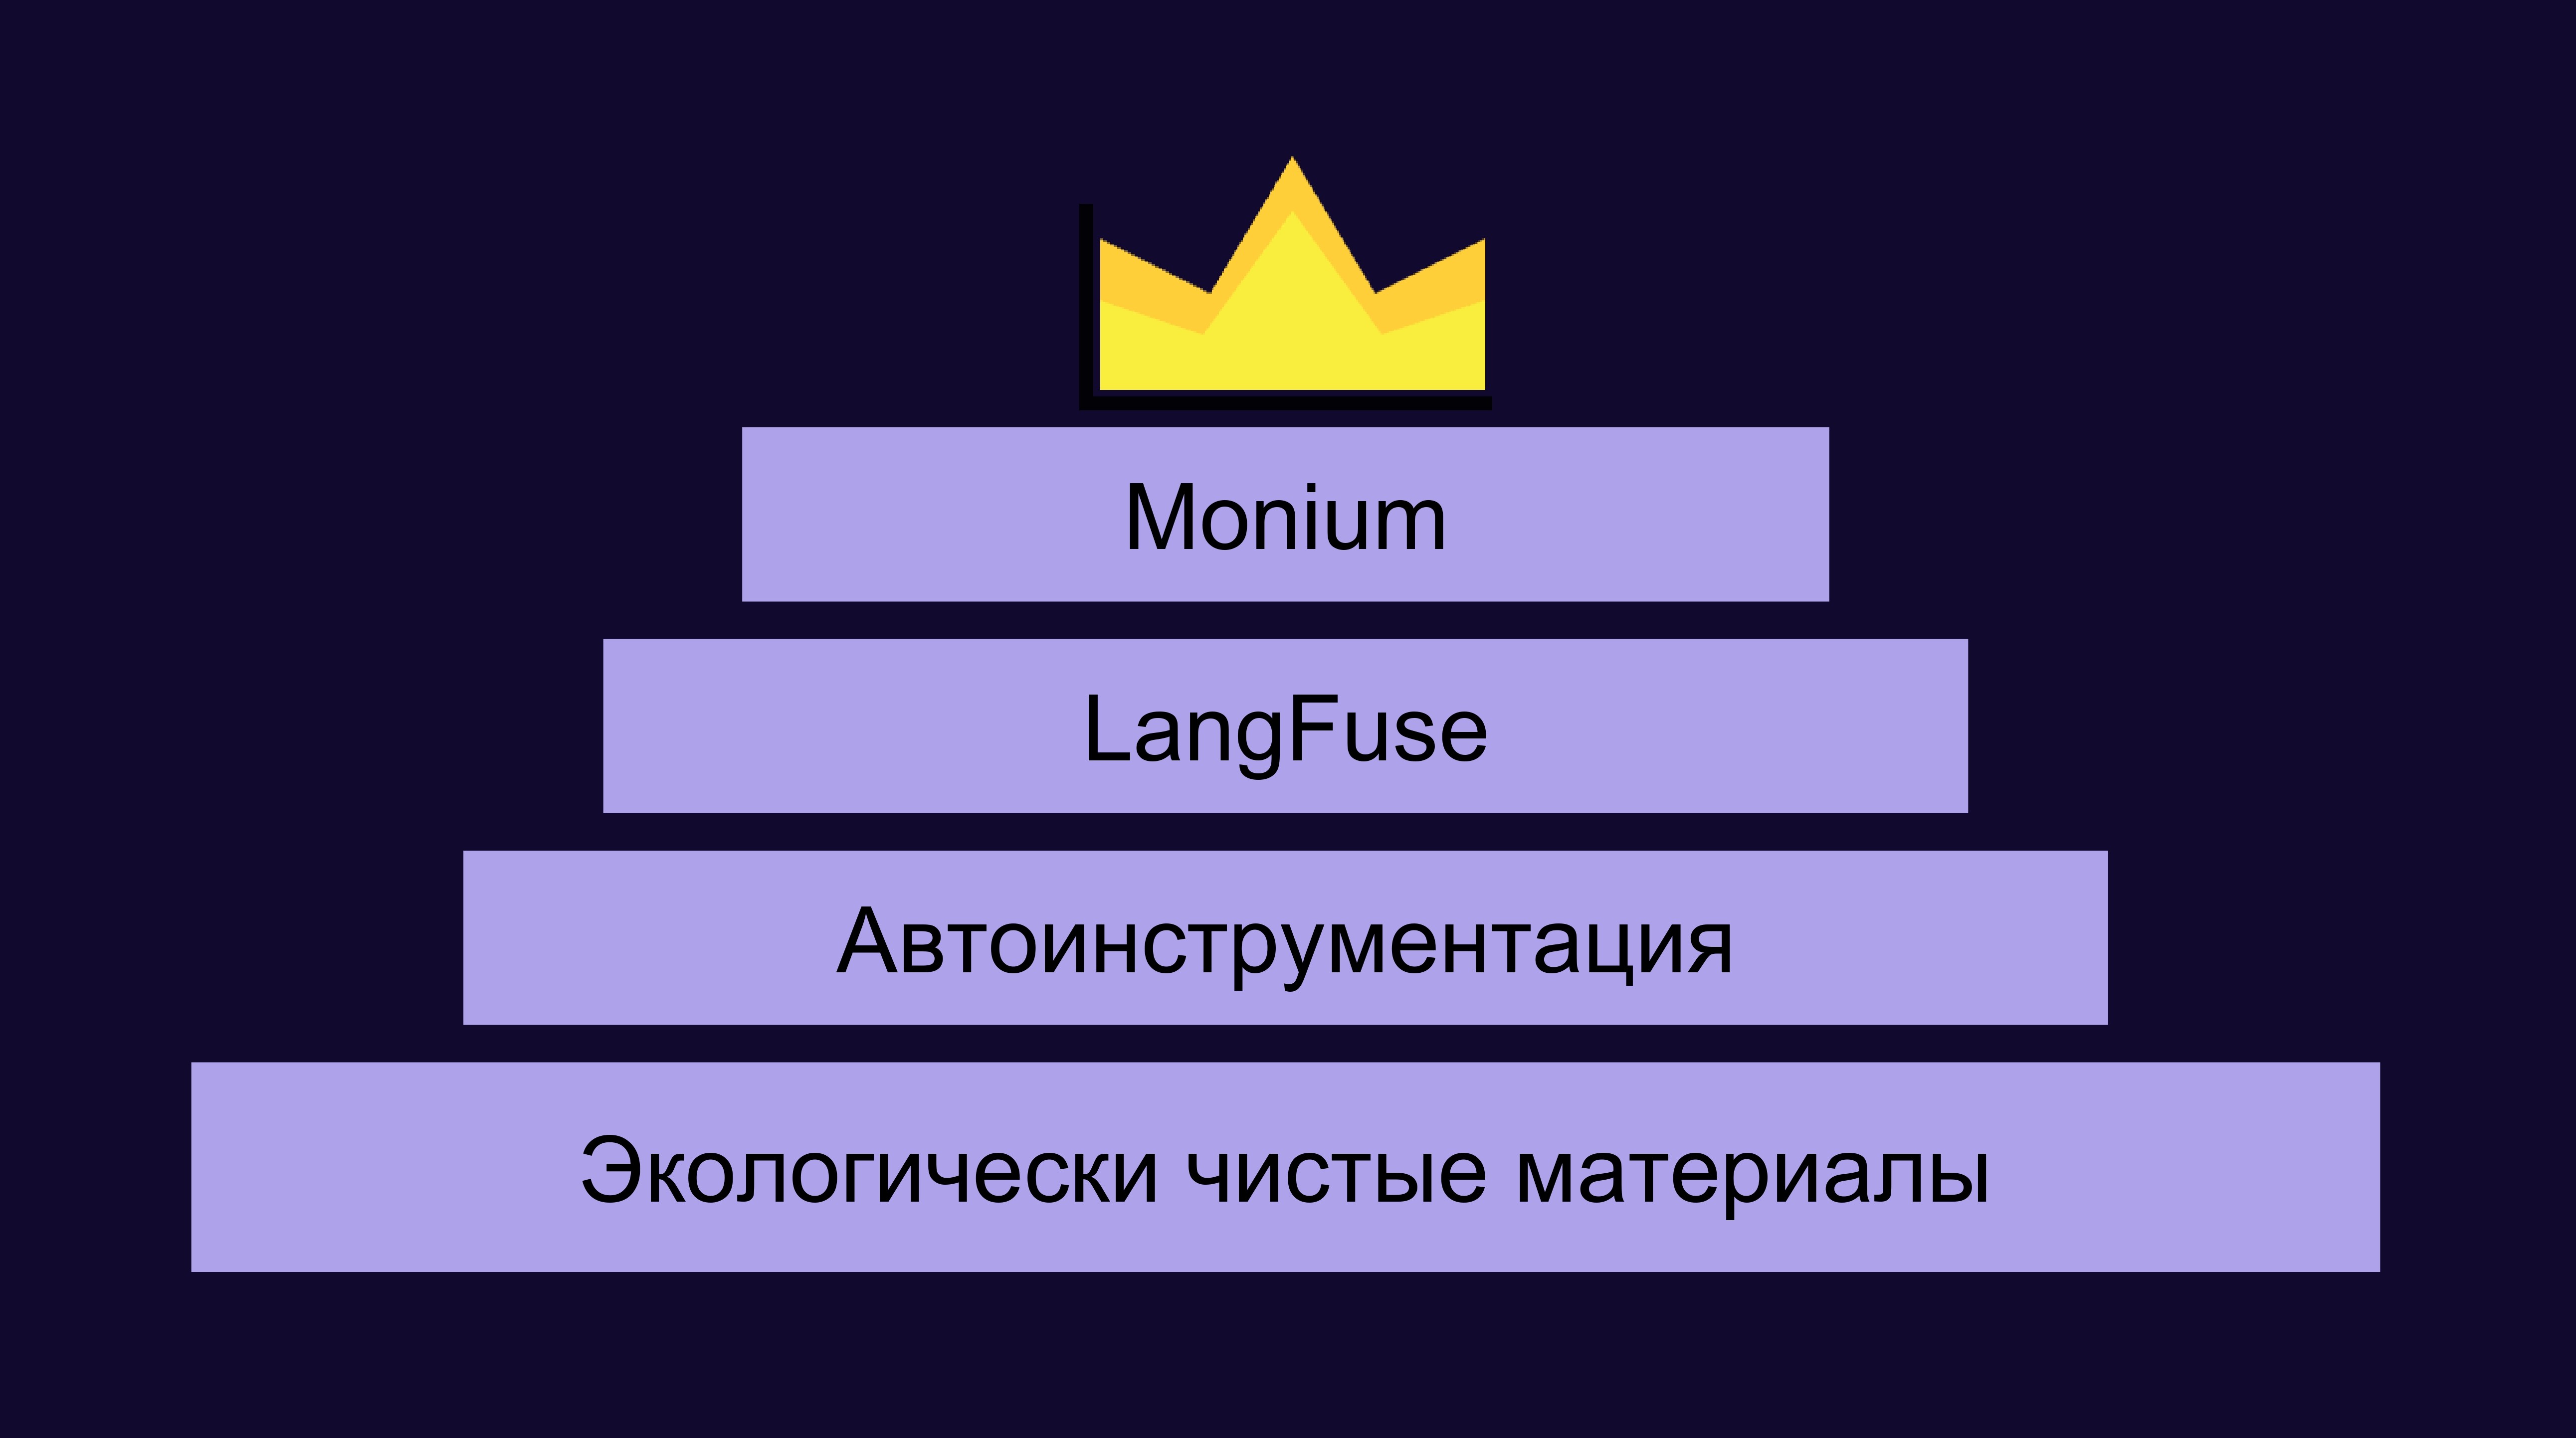
Вот набор рекомендаций в формате некоторой пирамиды зрелости:
-
Нулевой уровень — логи. Если у вас уже есть какие-то агенты, то важно разобраться с тем, куда они пишут логи. А если не пишут, сделайте так, чтобы писали. Логи дают шанс разобраться, если что-то пойдёт не так.
-
Первый уровень — OpenTelemetry и имеющиеся у вас инструменты мониторинга (например, Grafana, Jaeger). Стоит включить в них автоинструментацию от OpenTelemetry, чтобы агент начал что-то писать в те инструменты, которые у вас уже есть.
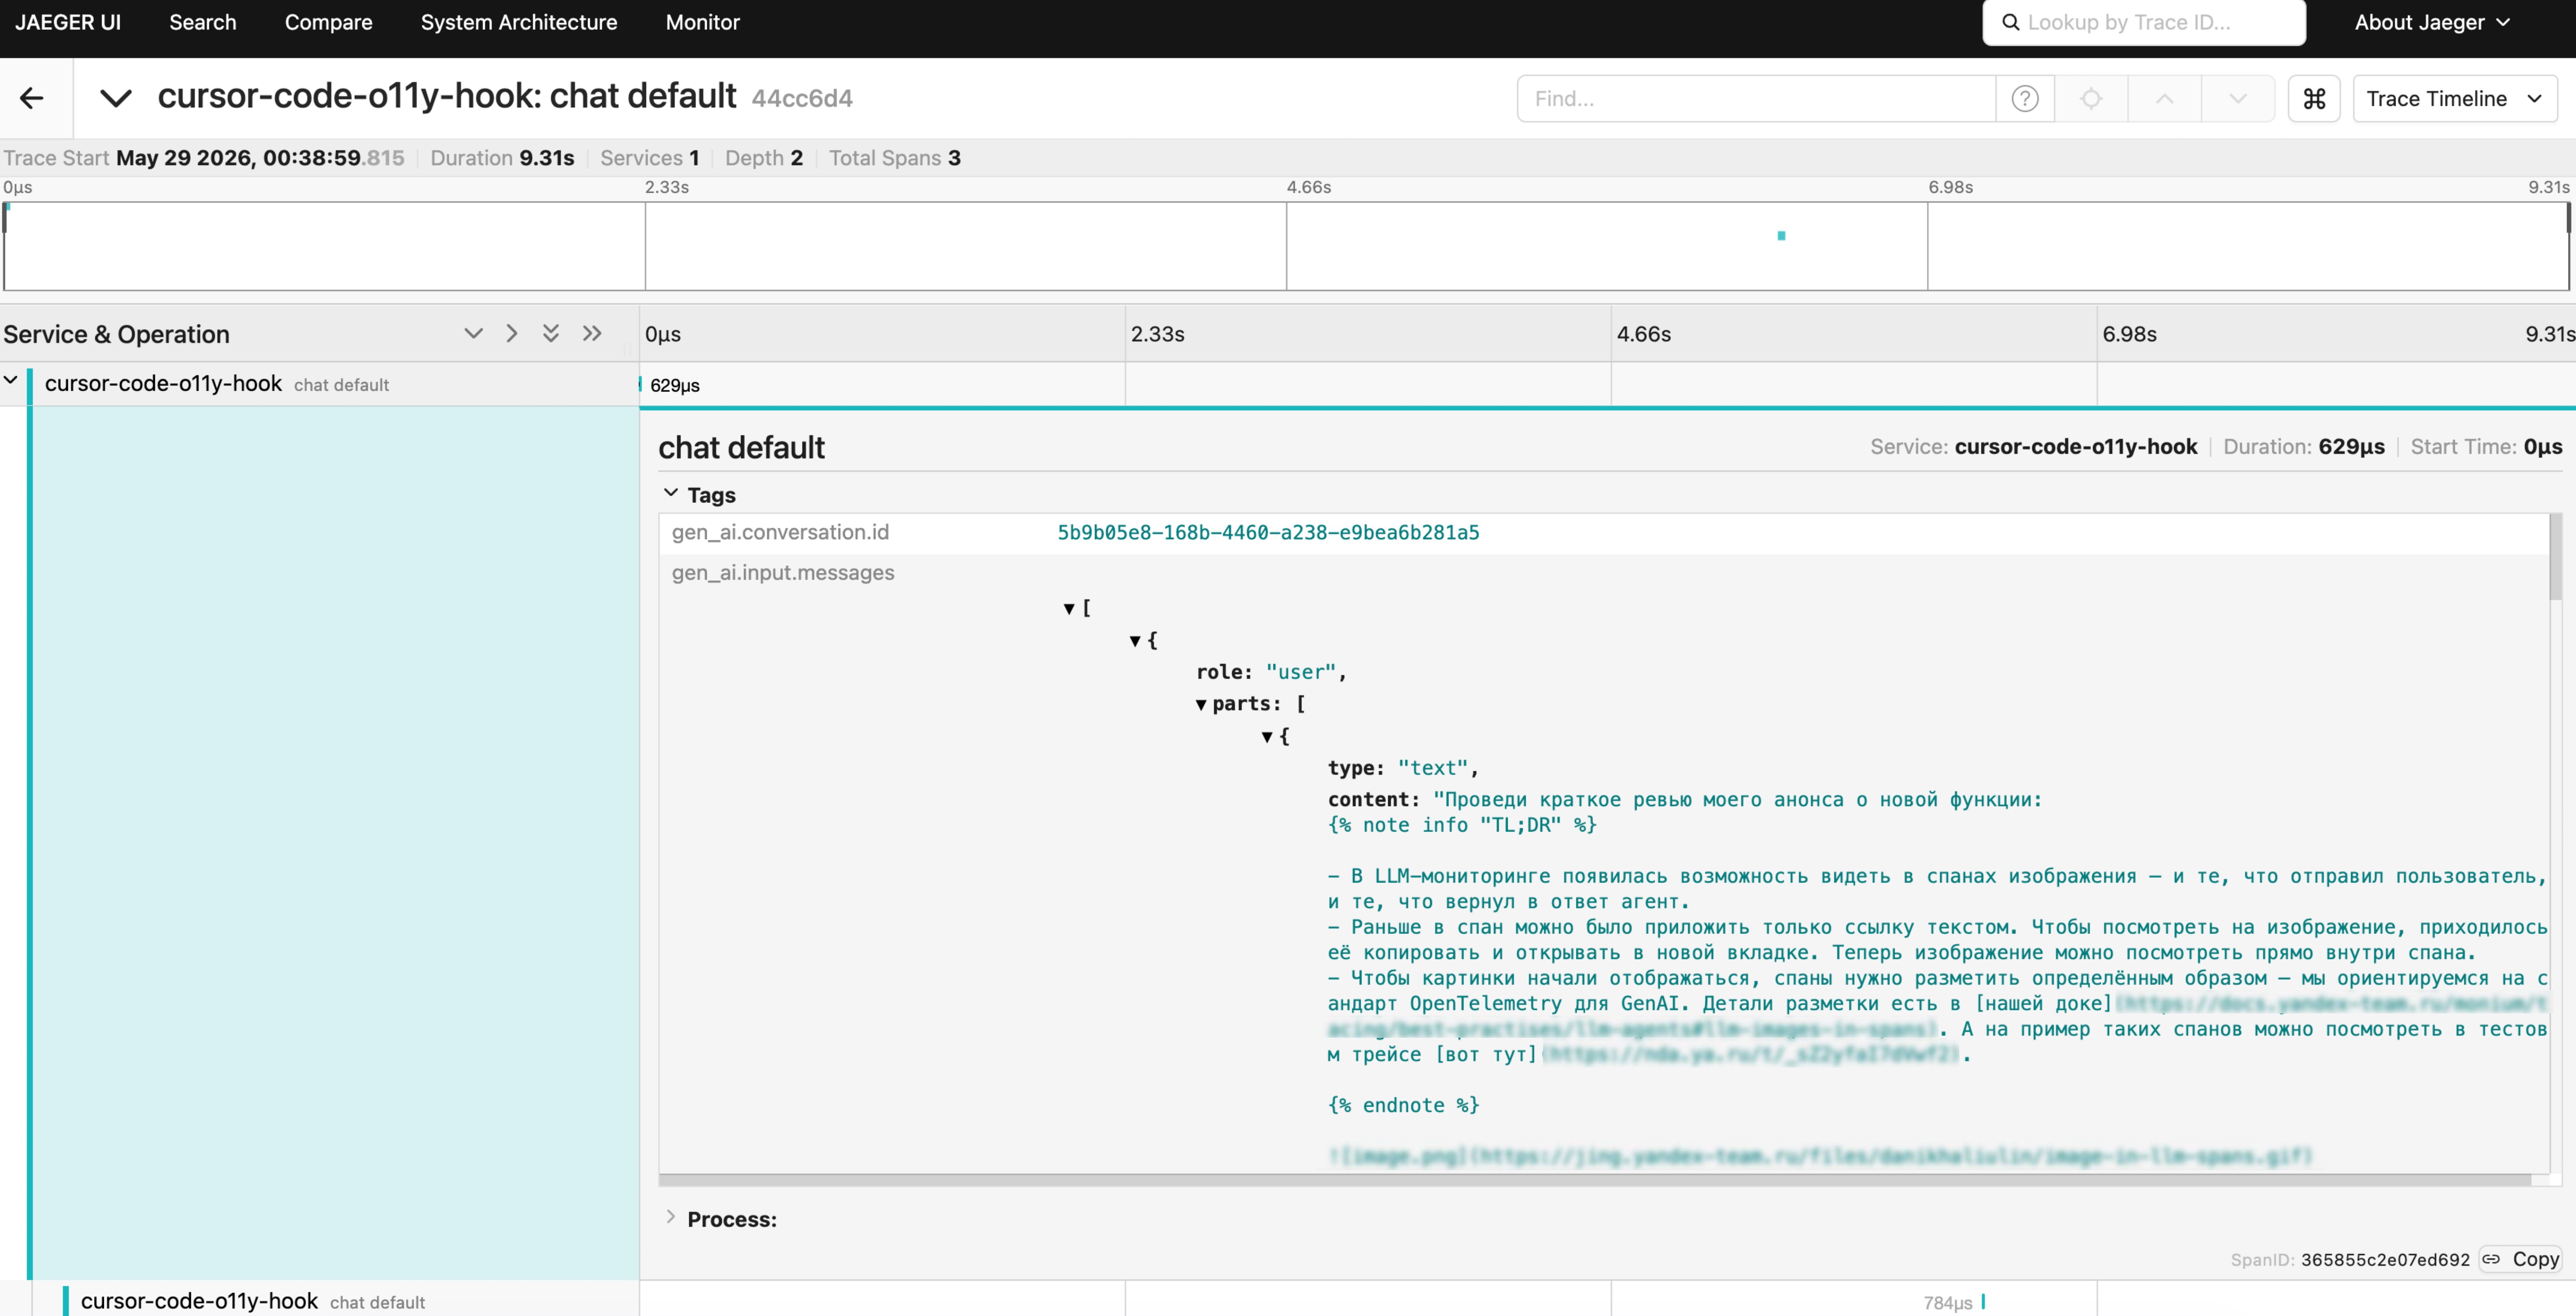
Обычные трейсы, конечно, будут большими и неудобными, но зато инструмент привычный.
По умолчанию библиотеки OpenTelemetry дают немного логов и увесистые трейсы. Но надо помнить, что для каждой библиотеки, на которой написан ваш агент, есть свои библиотеки OpenTelemetry. И второй нюанс: в свежих версиях библиотек для автоинструментации по умолчанию отключается трекинг самых больших текстов. Если его не включить вручную, то вы эти тексты не увидите, а значит, трейсы потеряют свою ценность.
- Второй уровень — специальные инструменты для мониторинга агентов. Например, LangFuse — это бесплатная opensource-платформа для разностороннего мониторинга агентов. В ней есть трейсы, эвалы, версионирование промптов и многое другое. Это действительно классная и полезная система.
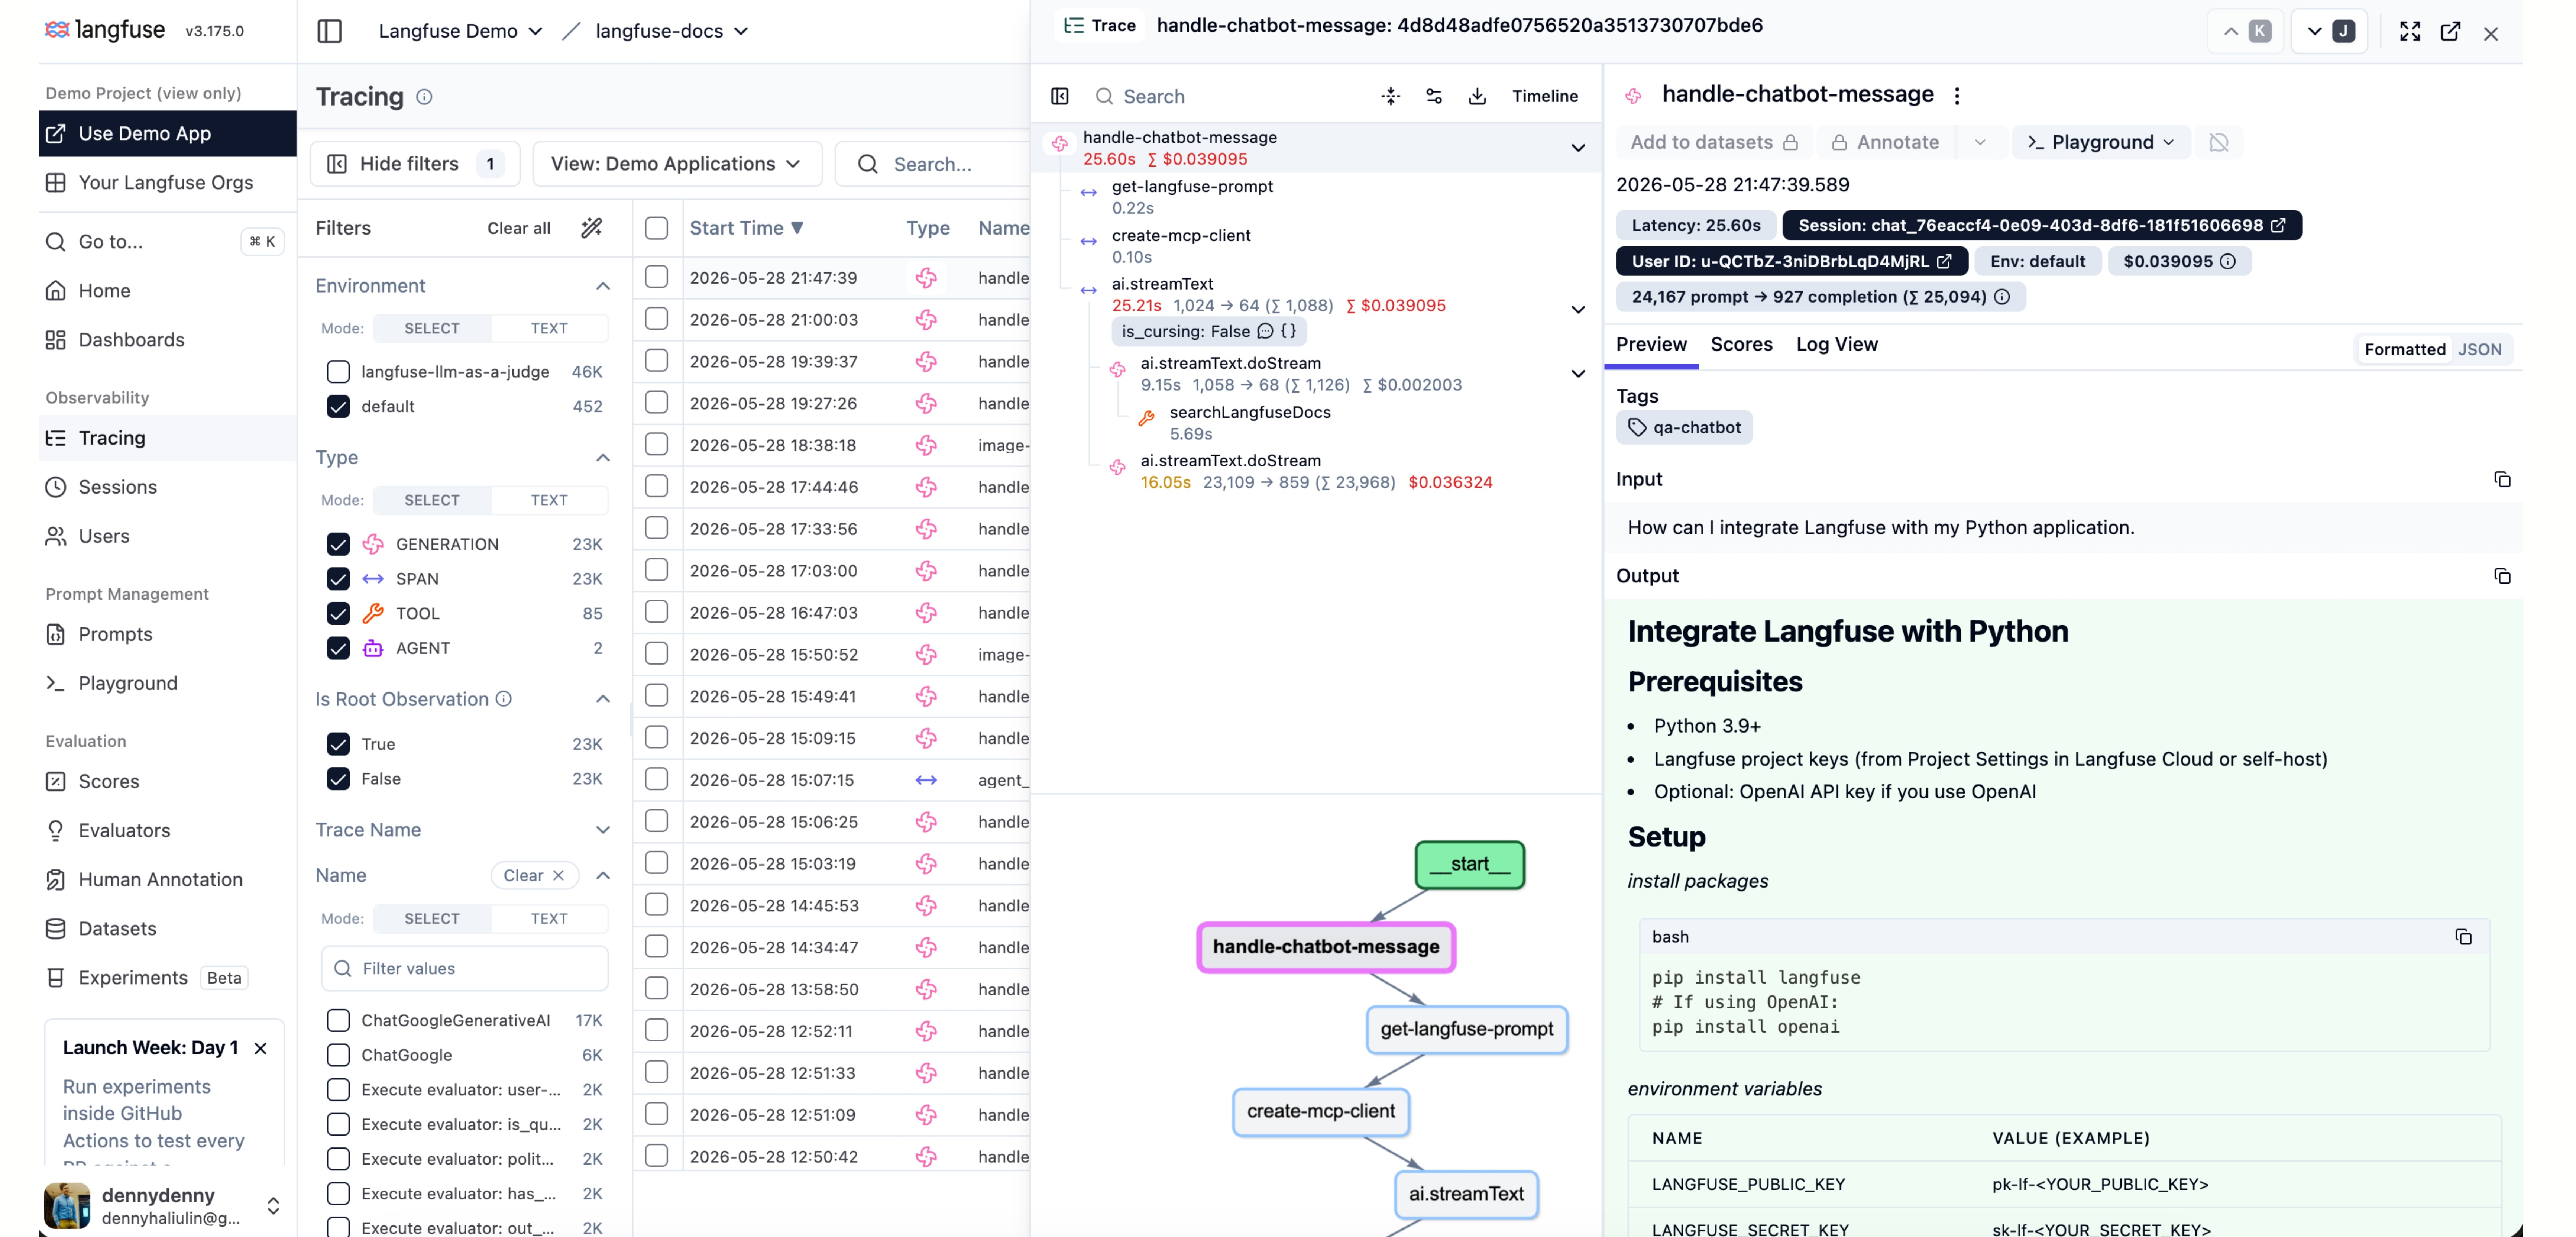
- Третий уровень — продукт Яндекса Monium, менеджером которого я являюсь. Подключайтесь и вы сразу «запрыгнете» на вершину этой цепочки. Если серьёзно, то сейчас ключевое для ИИ-агентов — это удобная визуализация трейсов. В Monium мы сместили акценты трейсов так, чтобы большие тексты были в фокусе и отображались нагляднее. В нашем UI удобно смотреть историю сообщений, входные и выходные параметры инструментов. А те, кому нужно больше глубины, могут посмотреть атрибуты всех спанов в первозданном виде.
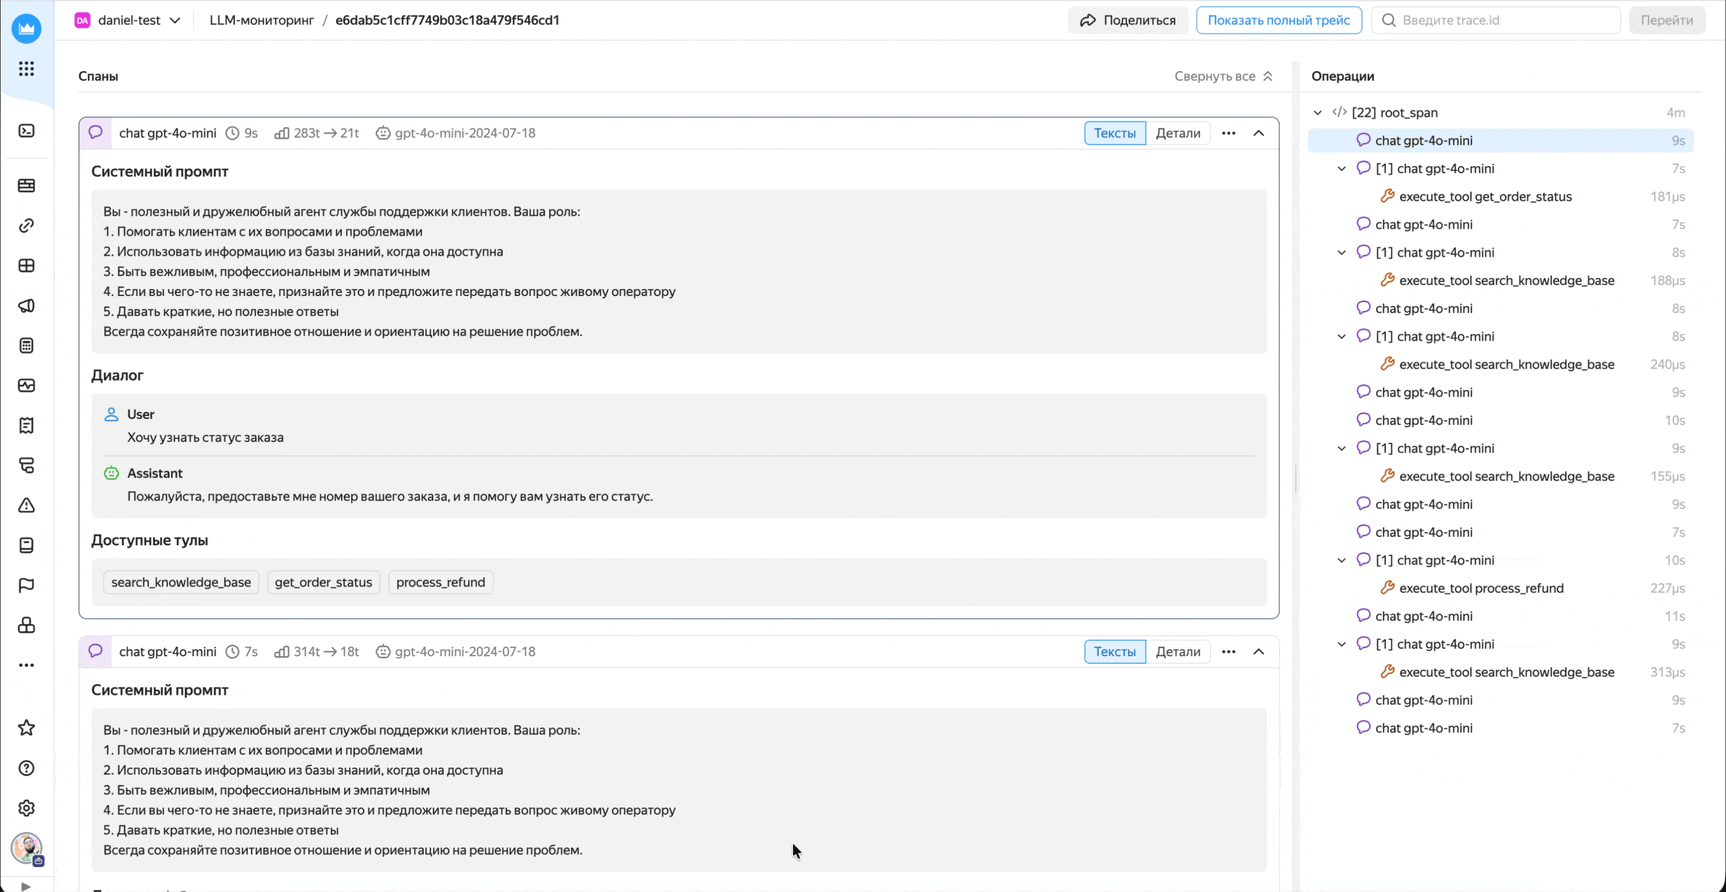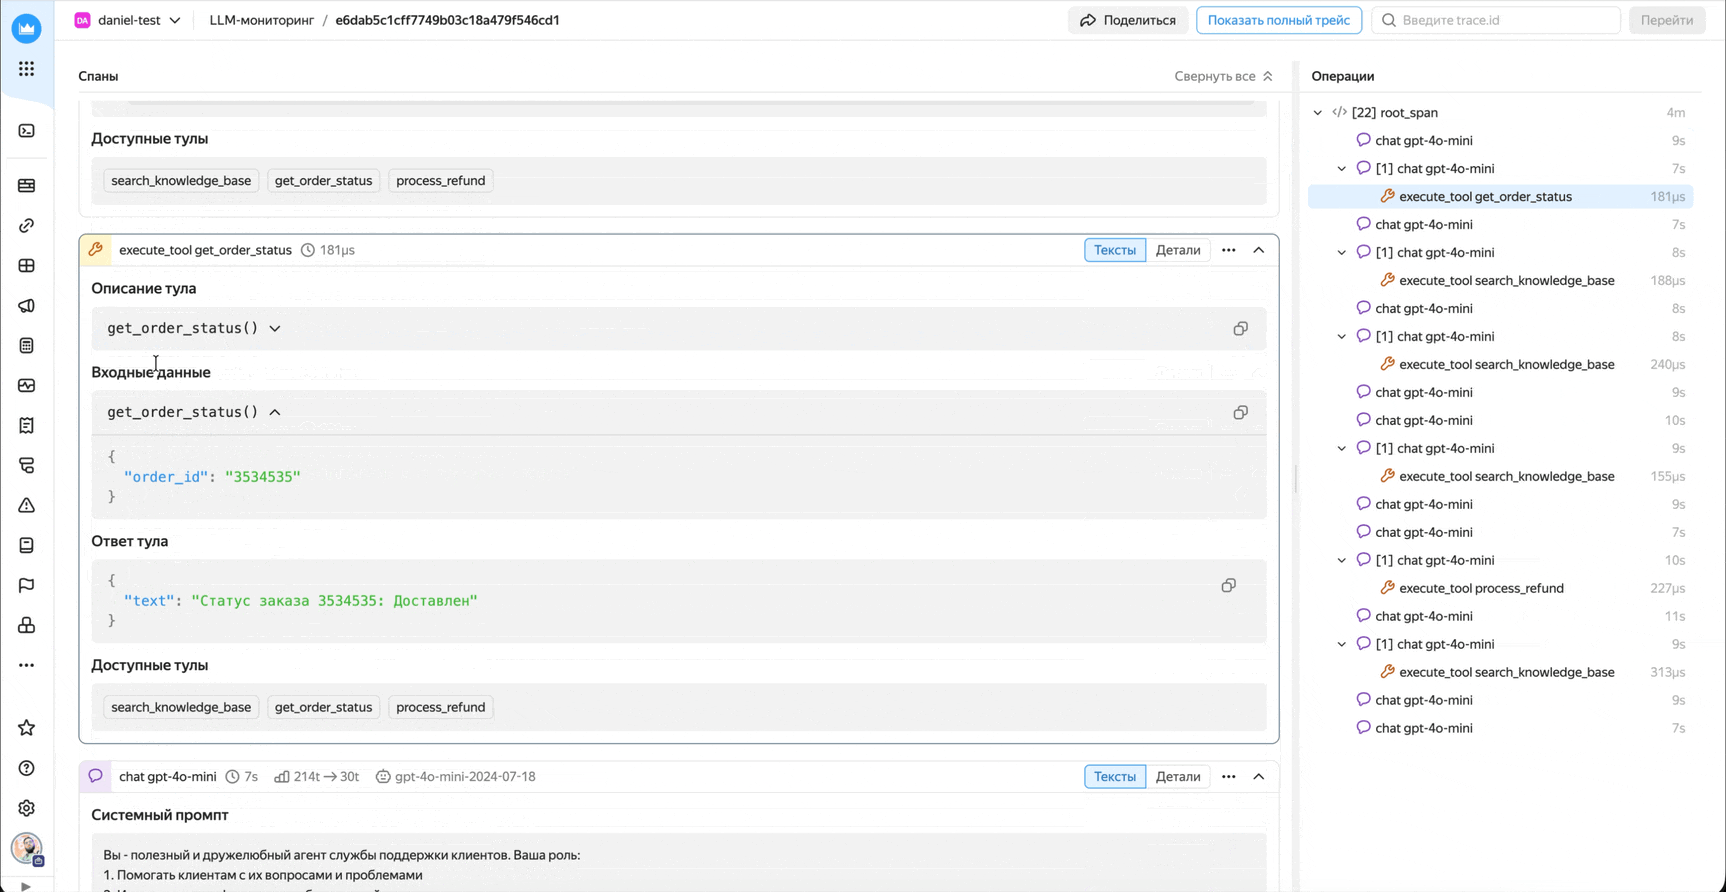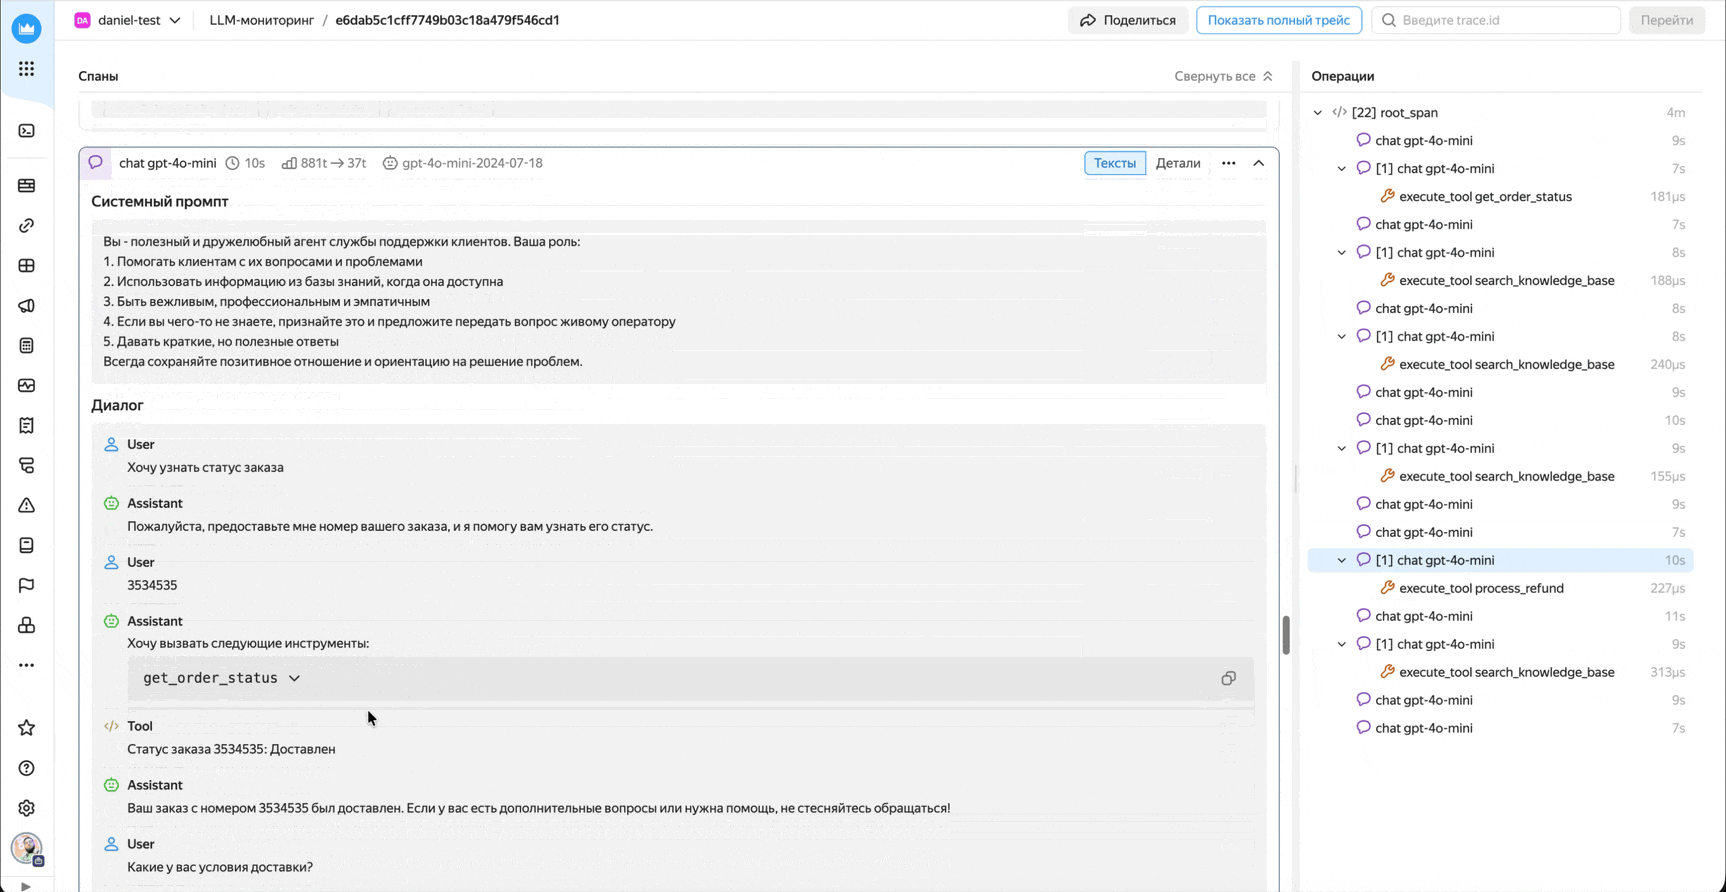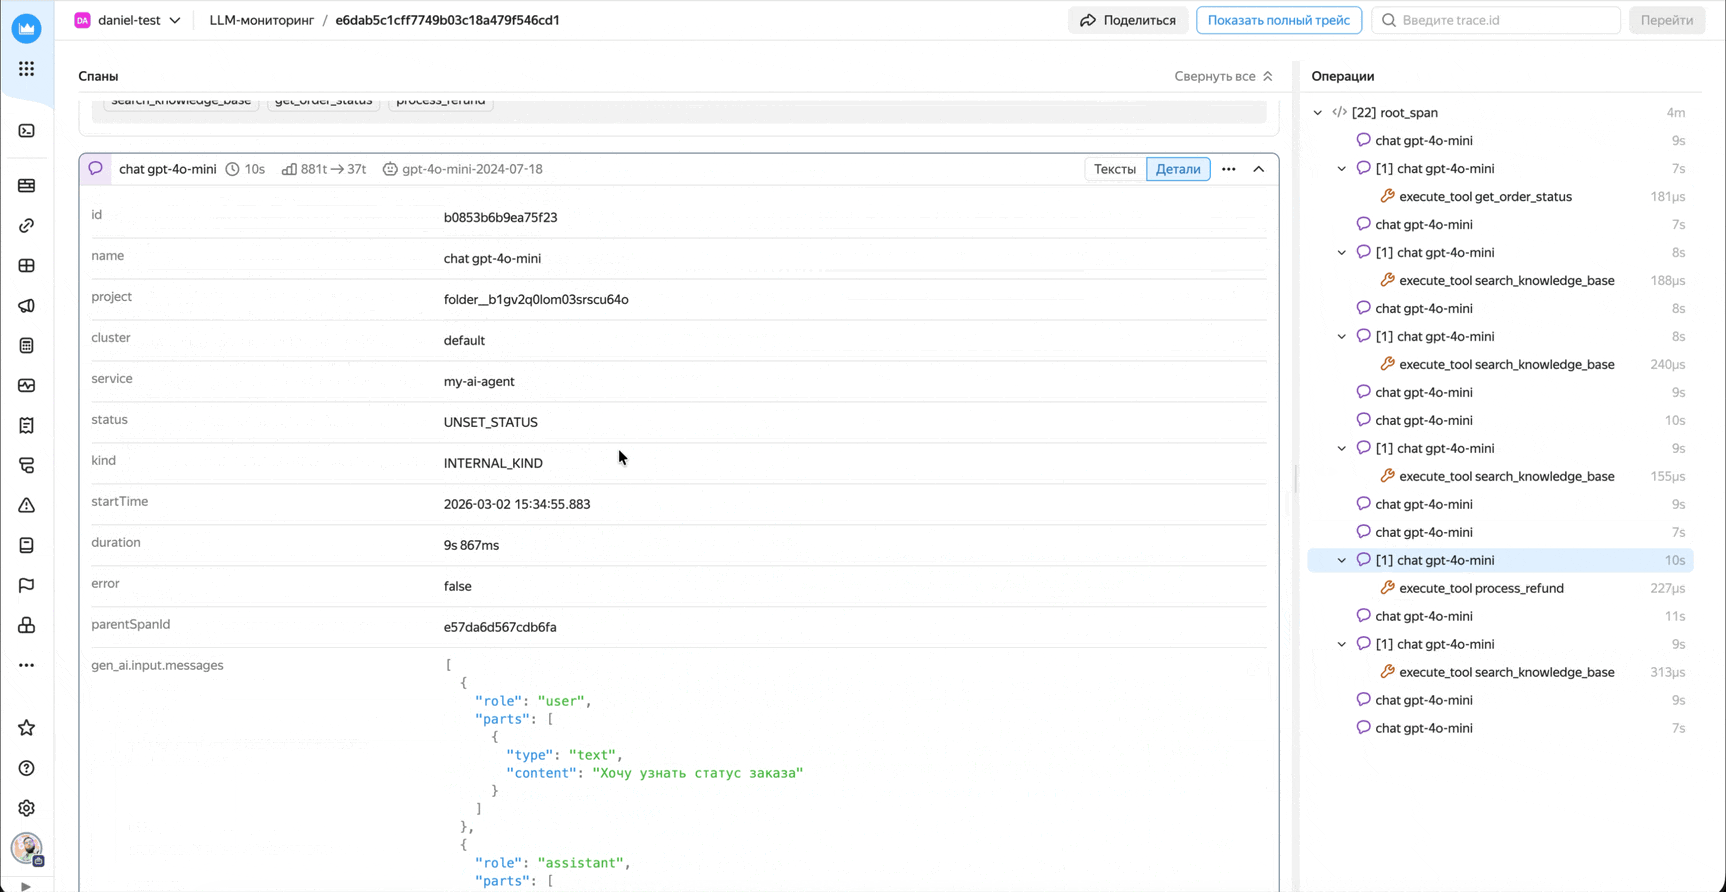
В Monium можно отправлять трейсы от своих агентов, и для этого не нужно ничего разворачивать: он уже работает в Яндекс Облаке и готов принимать трейсы хоть с вашего ноутбука.
Здесь мы подробно рассказали о том, как начать работу с Monium, чтобы понять, подходит ли он для ваших задач. Работать можно как в интерфейсе Yandex Monium с полным observability-контуром, так и в Yandex AI Studio — в интерфейсе создания и отладки агентов.
Каким должен быть «счётчик Гейгера» для ИИ-агентов
Итак, при построении системы наблюдаемости ИИ-агентов важно учитывать особенности их мониторинга:
- ключевыми данными для дебага стали большие тексты, а главным сигналом для анализа поведения агентов — трейсы;
- при создании системы метрик нужно настраивать сегментацию по виду задачи, учитывать контекст и семантические ошибки;
- сделать оценку качества работы агентов помогут эвалы и уже зарекомендовавшие себя инструменты — OpenTelemetry, LangFuse и Yandex Monium.
Тему агентов и их наблюдаемости, настройки мониторинга и другие вопросы обсуждаем в сообществе Monium. Присоединяйтесь — будем рады пообщаться.