Если вам интересны ML-технологии, помогающие улучшать популярные продукты, приходите в команду. Сейчас мы в поисках Руководителя группы разработки, который будет управлять небольшой командой, курировать кросс-командные проекты и писать код для сервисов будущей ML-платформы Яндекса.
Как работает поиск и генеративный помощник в интранете Яндекса
Как изменился внутренний поиск Яндекса, который экономит 320 рабочих часов и ускоряет обмен знаниями в компании? Дмитрий Кирпа, разработчик ML Laboratory, рассказывает об обновлениях и внедрении AI Chat в поиск по интранету.
10 августа 2026 г.
15 минут чтения
Привет! Меня зовут Дима Кирпа, я четыре года делаю внутренний поиск Яндекса. Расскажу, как устроен наш поиск и как на его базе мы построили генеративную систему AI Chat. Также посмотрим, какие внедрения мотивировали практических всех сотрудников использовать внутренний поиск и сделали его вторым по популярности MCP в контуре Яндекса.
Зачем вообще большой организации нужен быстрый поиск по интранету? Если знания компании — это топливо, поиск — это двигатель, а LLM — кузов, то компания превращается в болид, в котором процесс обмена знаниями происходит максимально быстро, а значит, быстро решаются корпоративные задачи.
Чтобы этого достичь, мы настроили массу сложных процессов, связанных с обработкой огромного объёма данных. В индексах внутреннего поиска Яндекса, которому уже почти 17 лет, — свыше миллиарда документов из более чем 50 систем. Внутри хранятся Трекер, Вики, документация, инструкции, код, материалы по технологиям и разработке — масса всего.
Посмотрим на масштаб интранета Яндекса:
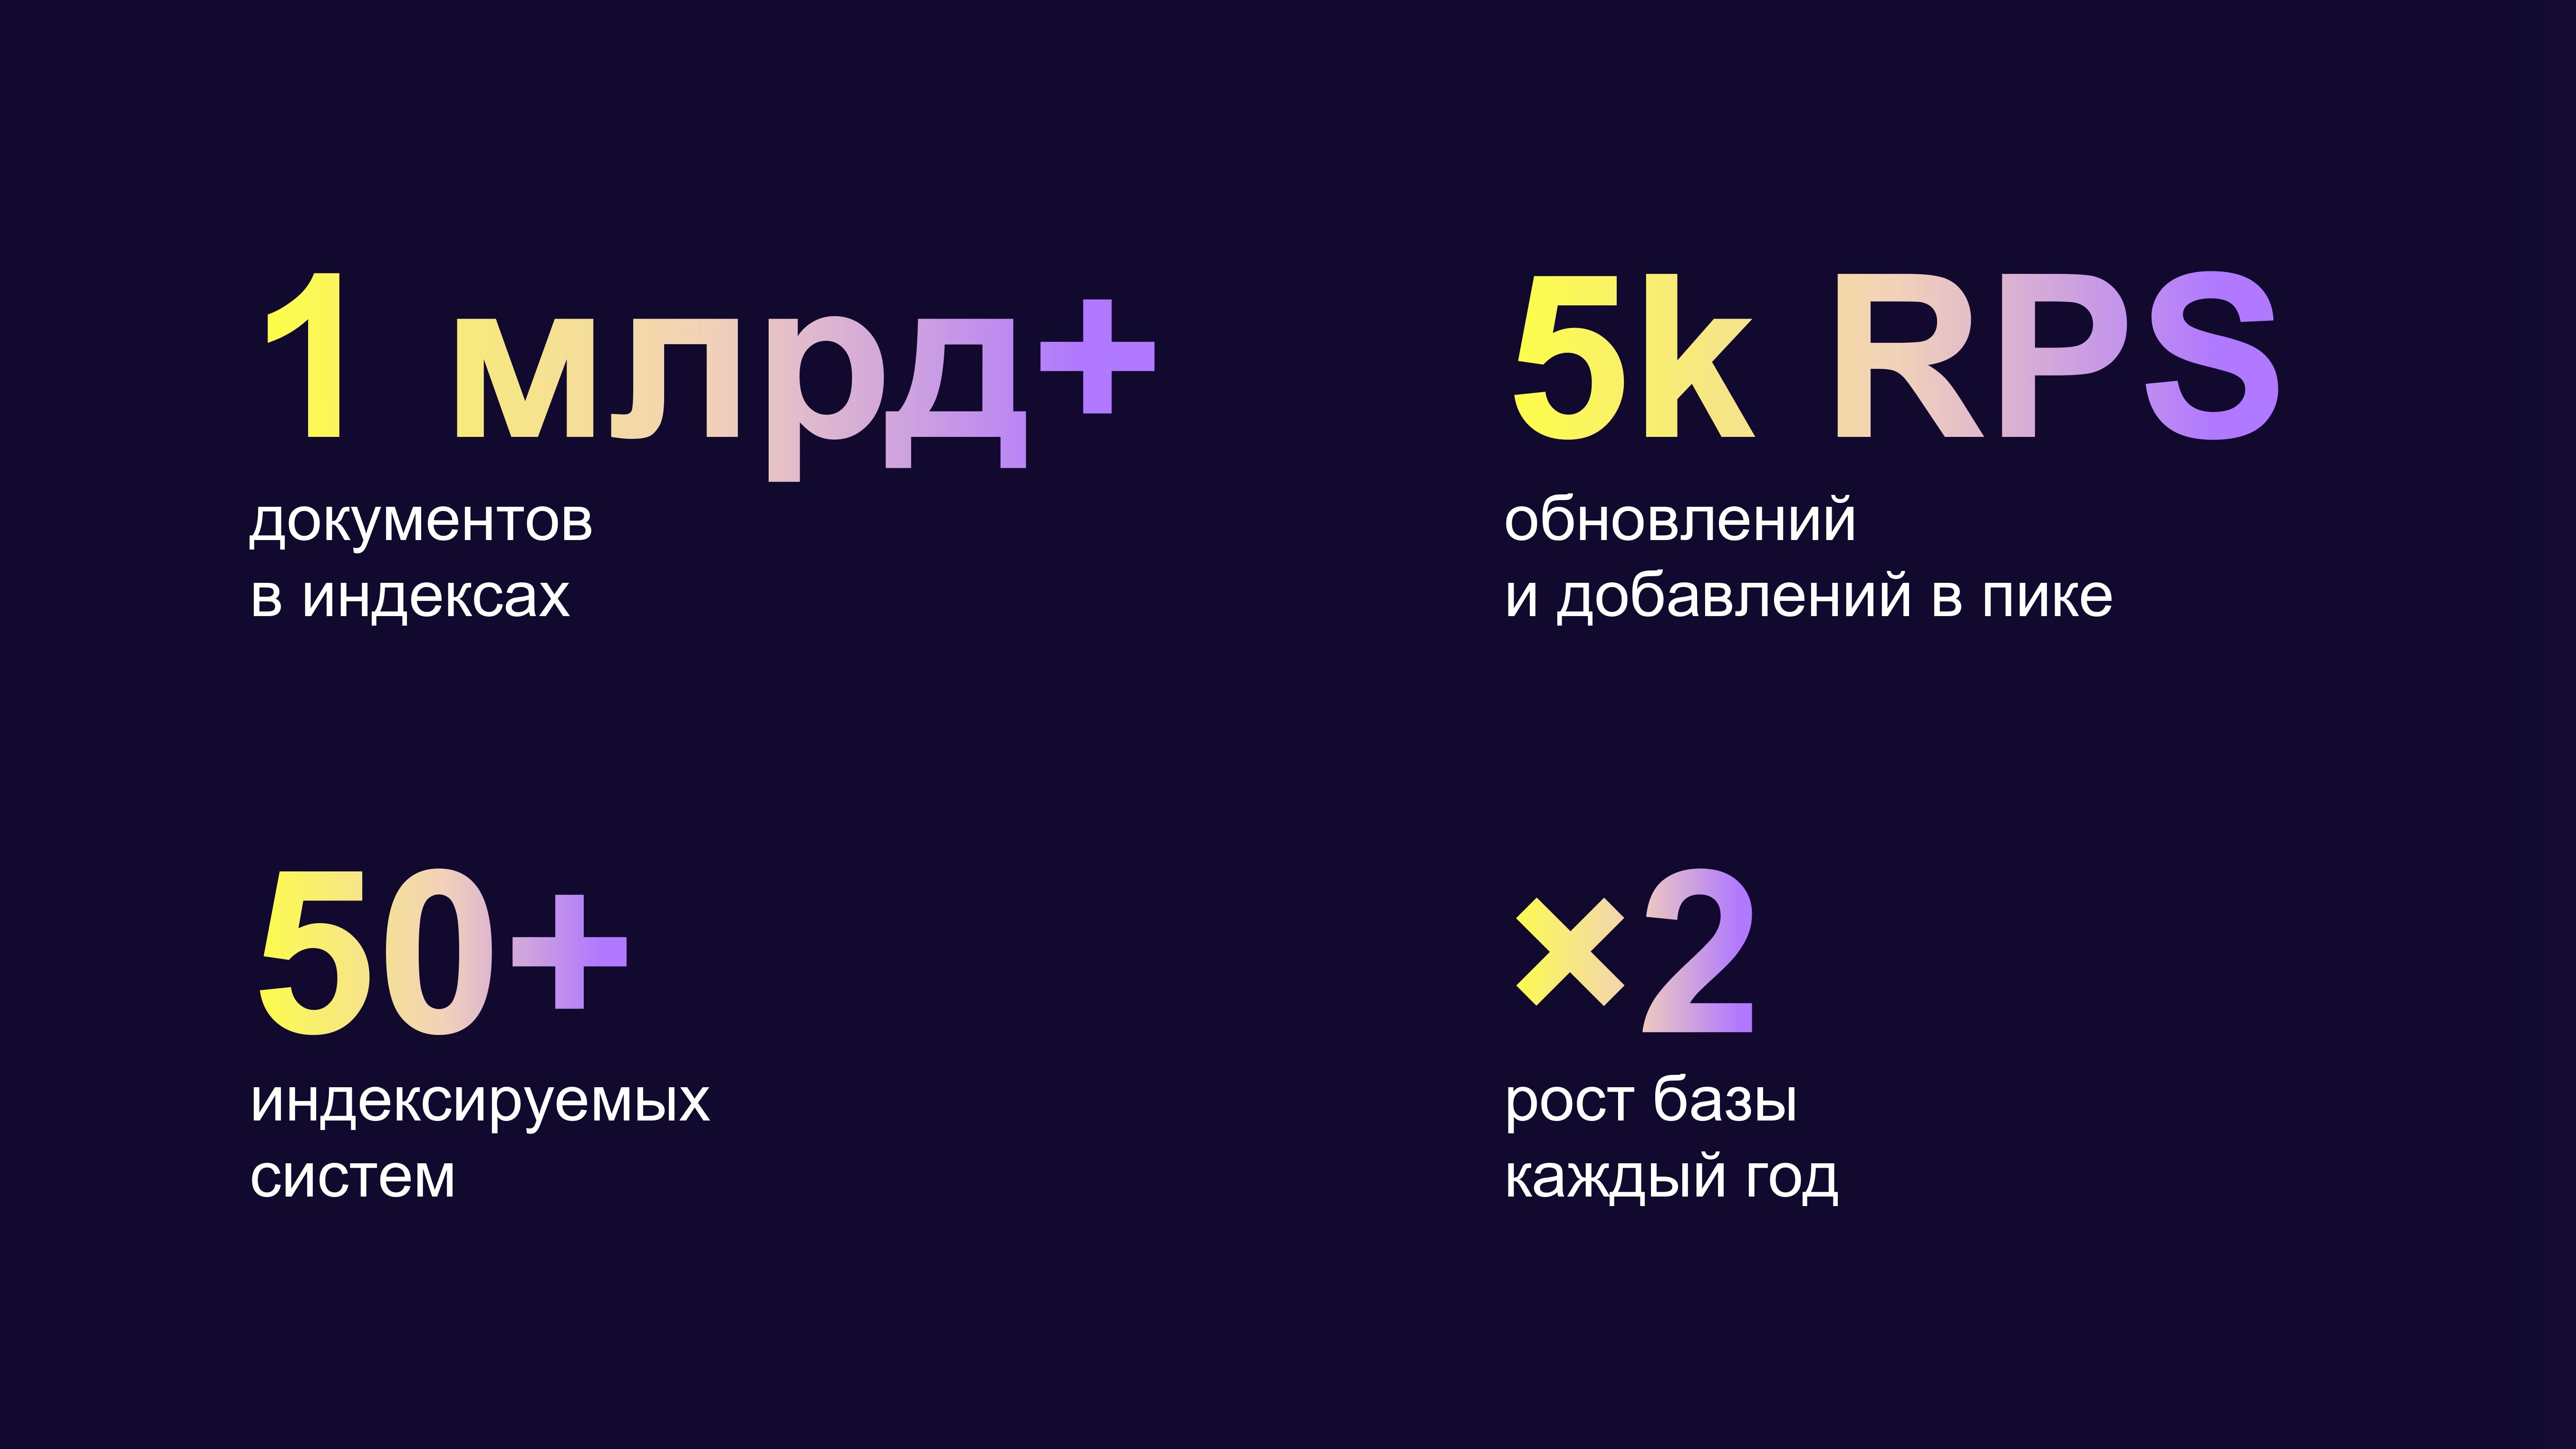
Ежегодно база растёт в два раза, она обновляется с высокой скоростью: иногда на индексацию прилетает более 5000 сообщений в секунду. Без качественных поисковых технологий обмен знаниями внутри компании будет сложным и медленным.
Вот с какими сложностями нужно разобраться при обновлении масштабного внутреннего поиска:
-
Проблема выбора систем — у нас их более 50, и перед тем, как что-то найти, пользователю нужно сначала выбрать, в какой системе это искать, а затем последовательно прокликать запросами эти системы. Например, если я хочу узнать, как пойти в отпуск, то в какую систему мне идти за информацией: в Трекер, в адаптационный тикет от HR-менеджера или на специальную вики-страницу? Разобраться трудно.
-
Проблема сложного корпоративного контекста — например, если разработчик ищет материалы по теме «модель», ему не нужны документы по 3D-моделям для дизайнеров: релевантными будут тексты про LLM.
Также непонятно, как сравнивать качество документов для ранжирования. Например, человеку очевидно, что документ от крутого тимлида, написанный неделю назад, релевантнее, чем документ по той же теме от уволившегося стажера, созданный семь лет назад. Но для LLM это не очевидно, поэтому нужно перечислять ей соответствующие правила. Может быть и наоборот: тимлид написал документ давно, а стажер недавно. Какой документ будет более релевантным? На такой вопрос не всегда могут ответить даже люди, агентам ещё сложнее.
-
Корпоративный сленг («птичий язык») — например, в интранете Яндекса YT означает YTsaurus, а LLM, скорее всего, «подумает», что речь идёт о YouTube.
-
Проблема наличия нужных знаний в базе: есть ли вообще знания в интранете или нет? Как понять, это LLM плохо ищет или в базе недостаточно документации по заданной теме?
Итак, если у компании нет качественных поисковых механизмов, у неё нет возможности анализировать потребности пользователей и оценивать уровень покрытия документацией всего того, что должно быть ей покрыто.
Кроме того, у сотрудников пропадает мотивация писать документацию: зачем, если документ всё равно никто не найдёт среди миллиарда материалов? Обмен знаниями внутри компании нарушается, и сотрудникам приходится тратить долгие часы на поиск нужных документов, доступы и решение простых задач.
Как устроен внутренний поиск Яндекса
Внешне он выглядит как привычная поисковая строка:
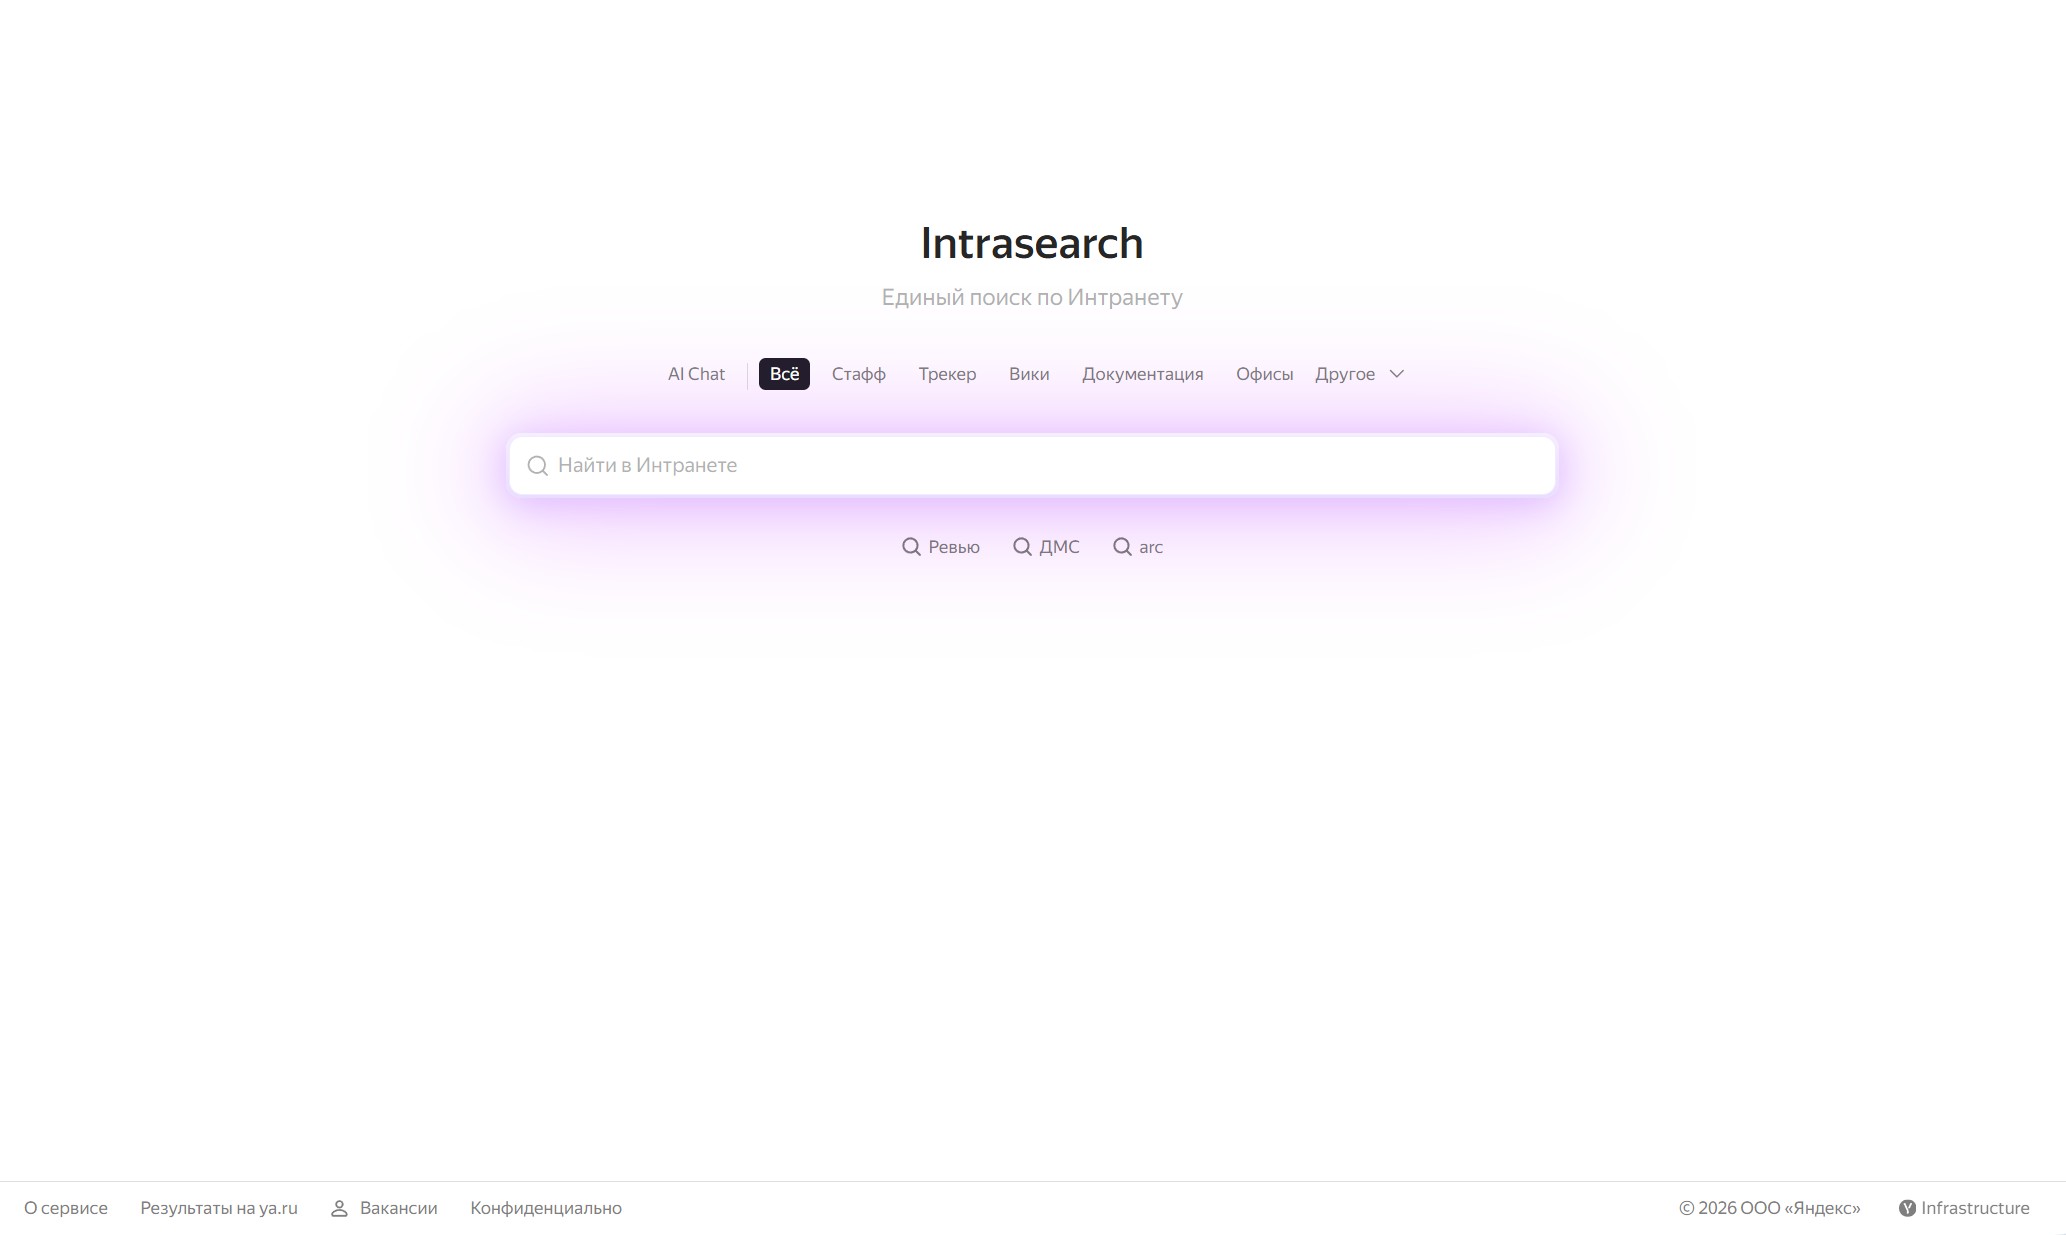
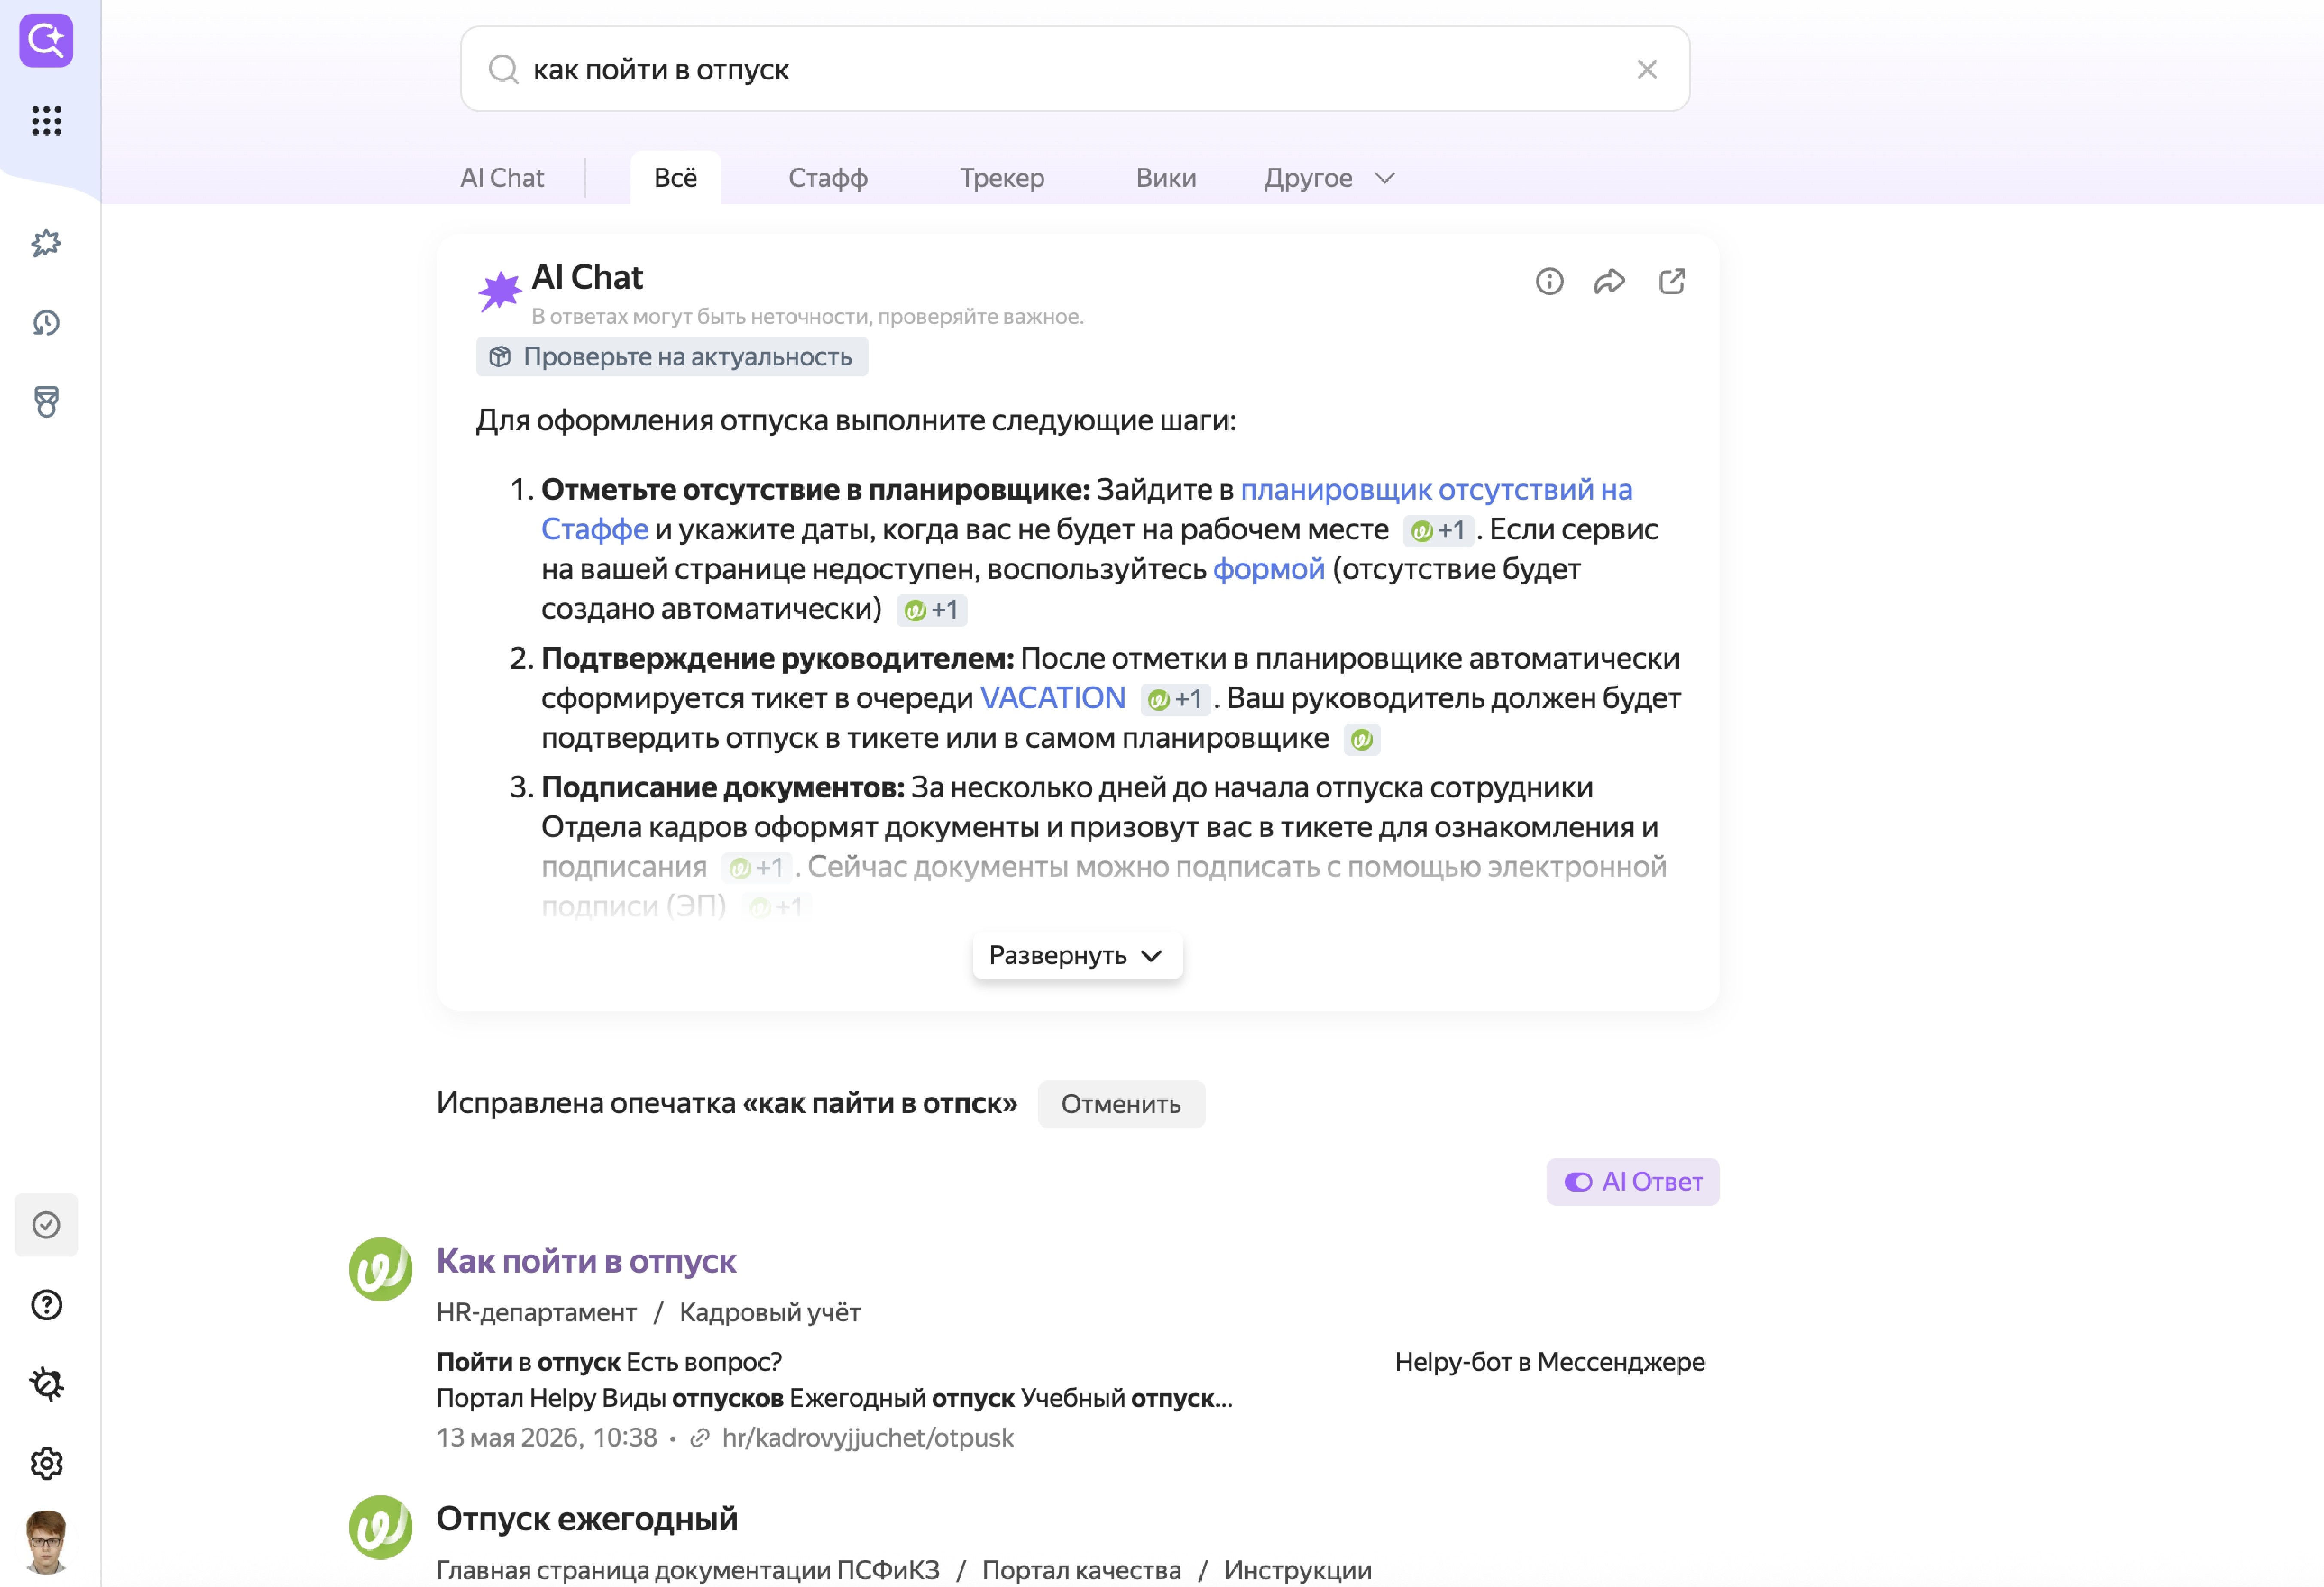
Пользователь пишет запрос и получает выдачу релевантных документов с ИИ-ответом, в котором указаны источники информации.
Вся система базируется на наших внутренних разработках. На вход система получает запрос пользователя, информацию про него и базу документов. По этой тройке система должна выбрать из базы топ релевантных материалов, которые подходят конкретному пользователю под конкретный запрос. Обычно только что созданный документ попадает в выдачу уже через минуты.
Дерево запроса
Как выглядит дерево запроса? Например, сотрудник решил пойти в отпуск и отправить заявление в отдел кадров. Он ввёл запрос так:
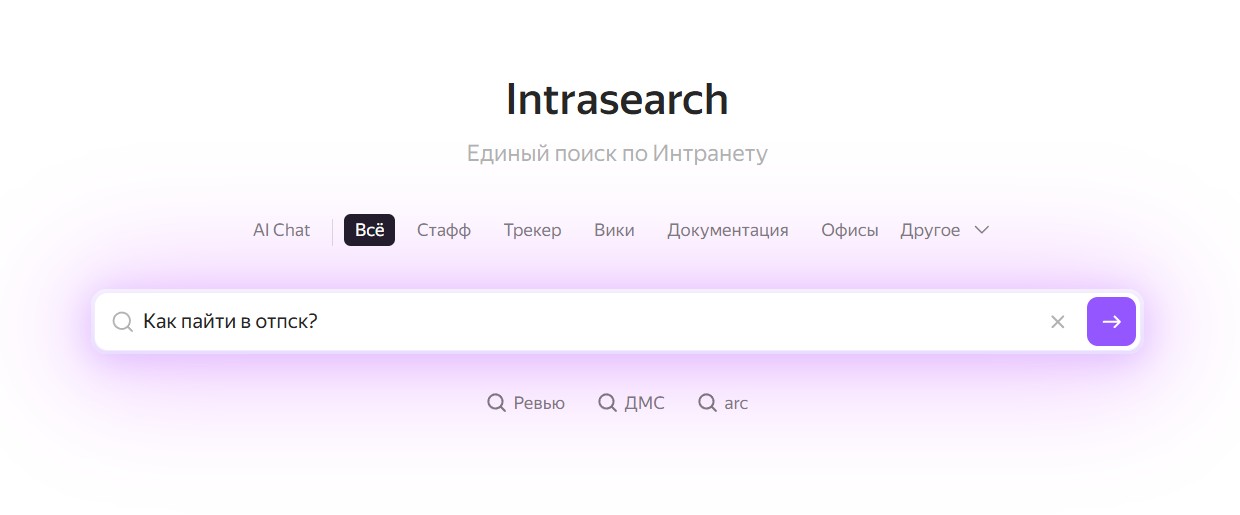
Чтобы LLM поняла его запрос, нужно переформулировать его, исправить опечатки, добавить синонимы и всё это объединить. На этом этапе мы как раз можем решить проблему корпоративного сленга или «птичьего языка». Каким образом?
Во внутреннем поиске есть огромный словарь с ИТ-терминами и понятиями Яндекса. Мы прогоняем каждое слово запроса через словарь, обогащаемся синонимами. Если речь о сценарии, когда у нас есть запас времени, мы используем LLM, которая поверх специального ранга смотрит на корпоративный словарь и формулирует более широкие запросы. Мы пытаемся понять не то, что пользователь написал, а то, что он на самом деле думал, когда вводил запрос.
Также к этим запросам нужно добавить право доступа пользователя, чтобы он случайно не попал на страницу с закрытой информацией. У нас LLM работает в системе RAG, а под LLM стоит поиск, который строго учитывает права доступа. Важно, что LLM не обучается на внутреннем корпусе по соображениям безопасности (чтобы она не запомнила закрытую информацию). Внутренний поиск работает строго по целям, случайного доступа к чувствительной информации быть не может. Точка контроля — это IDM.
В итоге получается дерево поискового запроса, которое отправляется в поисковый движок на базе внутренней технологии SaaS. Его интерфейс практически database-like: он принимает фильтры, склеенные логическими операторами.
Как формируется выдача: каскад
На широкие запросы наш поисковик может отдать десятки и сотни миллионов документов. Как их ранжировать? У нас высокие требования по скорости и стабильности, поэтому отранжировать миллионы на каждого пользователя никакой адекватной ML-моделью нельзя.
Мы нашли хитрое решение: берём статические факторы документа — фичи, которые характеризуют качество документа (дата обновления, возраст, количество кликов от пользователей), обучаем на этом логрек и закидываем в полином.
Во время индексации мы прогоняем каждый документ через этот полином, получая одно число, характеризующее качество документа. И на этапе поиска мы уже не занимаемся никаким применением полиномов и ранжированием, просто берём топ-N в отсортированном списке.
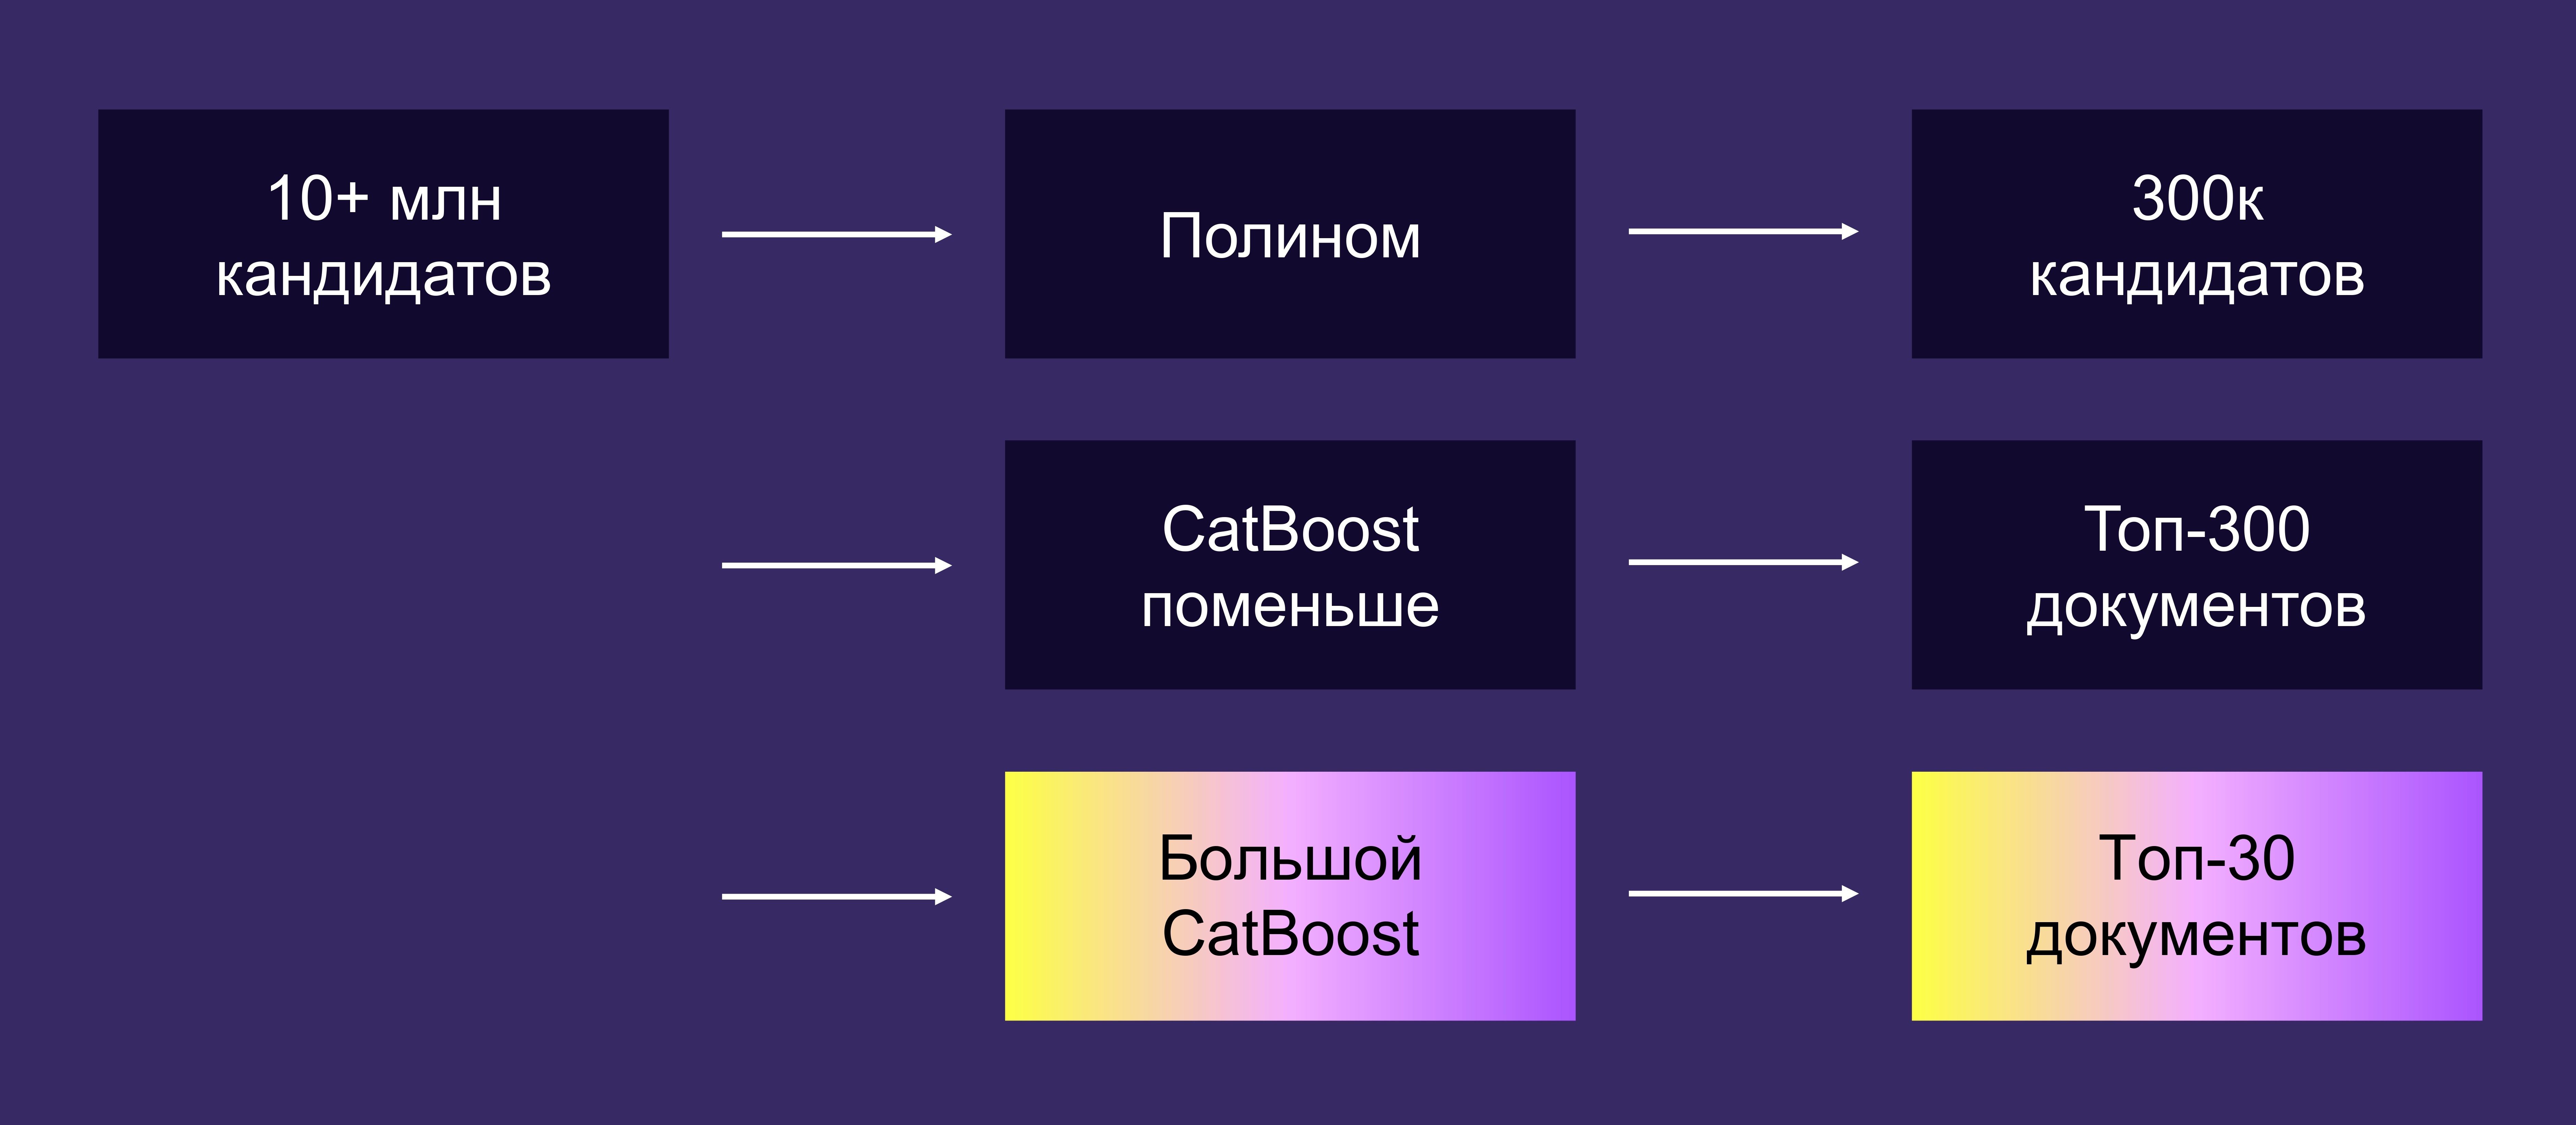
Например, документ, написанный роботом, по которому никто не кликал, скорее всего, искать не будут. Но если на документе миллион кликов и его писали вчера, то лучше положить его поближе к топу, чтобы модели могли его сразу увидеть.
После этого этапа мы получаем 300 000 документов, которые тем или иным образом подпадают под запрос пользователя. Далее применяется каскад ML-моделей, которые этот топ сужают до 30 самых релевантных документов. Работать с категориальными признаками помогает CatBoost (Categorical Boosting) — наш алгоритм машинного обучения, главный механизм которого — градиентный бустинг на деревьях решений.
CatBoosts между собой отличаются размером и количеством фичей, которые они видят на ранжировании. У маленького CatBoost меньше фичей, меньше размер, но он работает быстро и может отсортировать эти 300 000 кандидатов за адекватное время. Последний CatBoost огромный, тяжёлый, но качество у него выше: он может из трёхсот документов достать самые релевантные.
Базовое качество выдачи
Чтобы указанная система работала корректно, нужны три свойства ранжирующего алгоритма, выбирающего топ:
- близость таргета к тому, что реально хотят пользователи;
- качество самого алгоритма — хорошая описательная способность;
- качественные входные данные для поисковых моделей — их называют поисковыми фичами или факторами.
Мы используем более 2000 поисковых факторов в интранете:
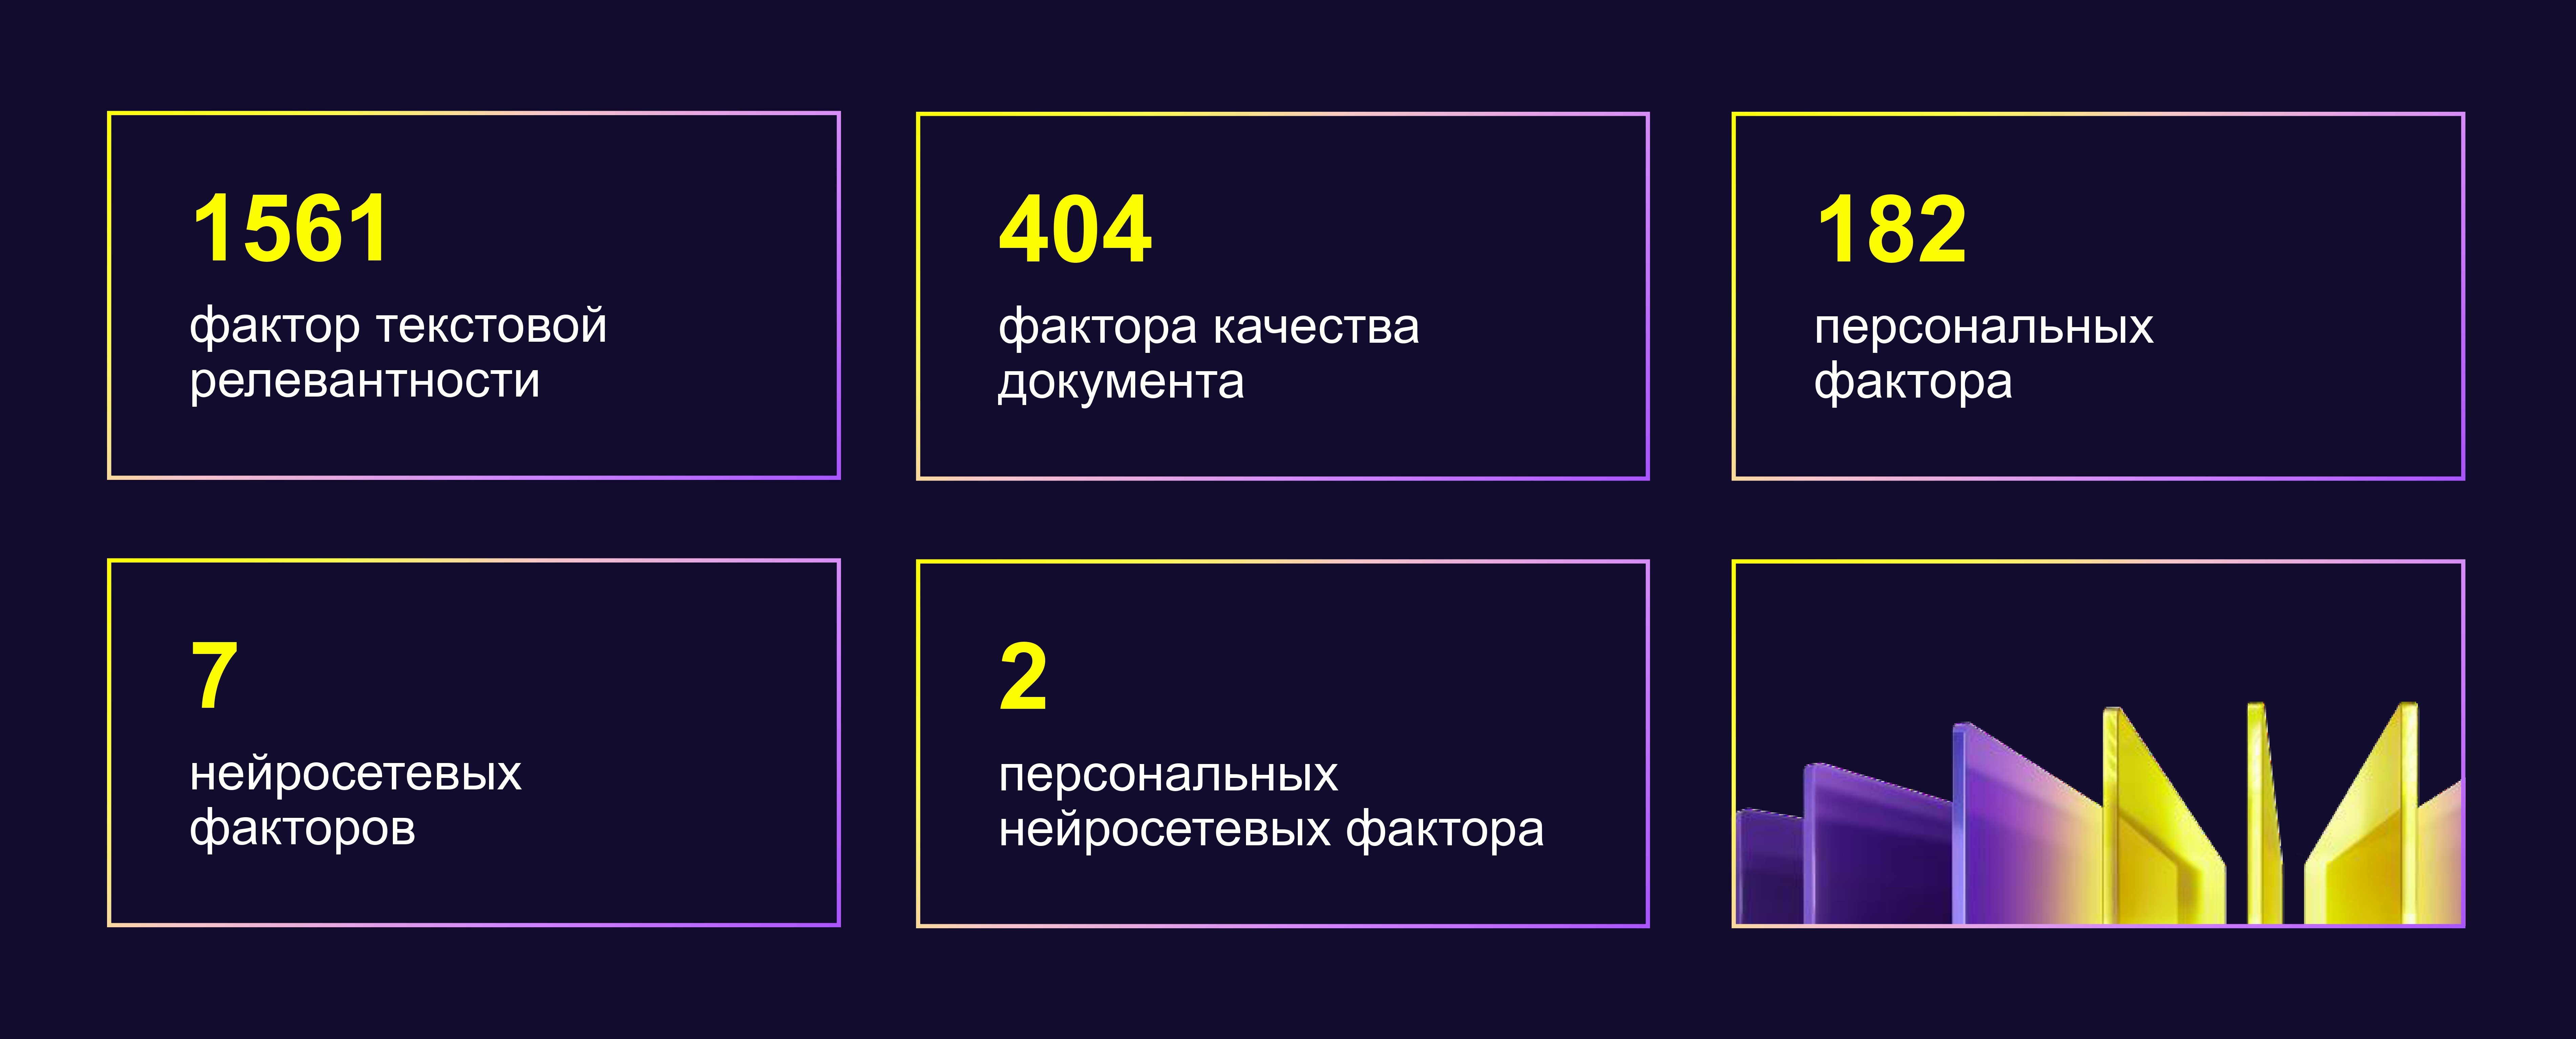
Три четверти из них — это факторы текстовой релевантности, почти четверть — факторы качества документа, около 200 фич — это факторы персонализации (насколько документ подходит пользователю). Есть также несколько нейросетевых факторов, два из которых — персональные нейросетевые.
Что такое персональные нейросетевые факторы
Раньше, занимаясь факторами персонализации, мы придумывали сложные эвристики. Например, пользователь вводит запрос, и нужно проверить, является ли документ созданным им самим документом. Пользователи часто пытаются найти свои документы в поиске. Или наоборот: нужно не показывать документы, которые написал сам пользователь.
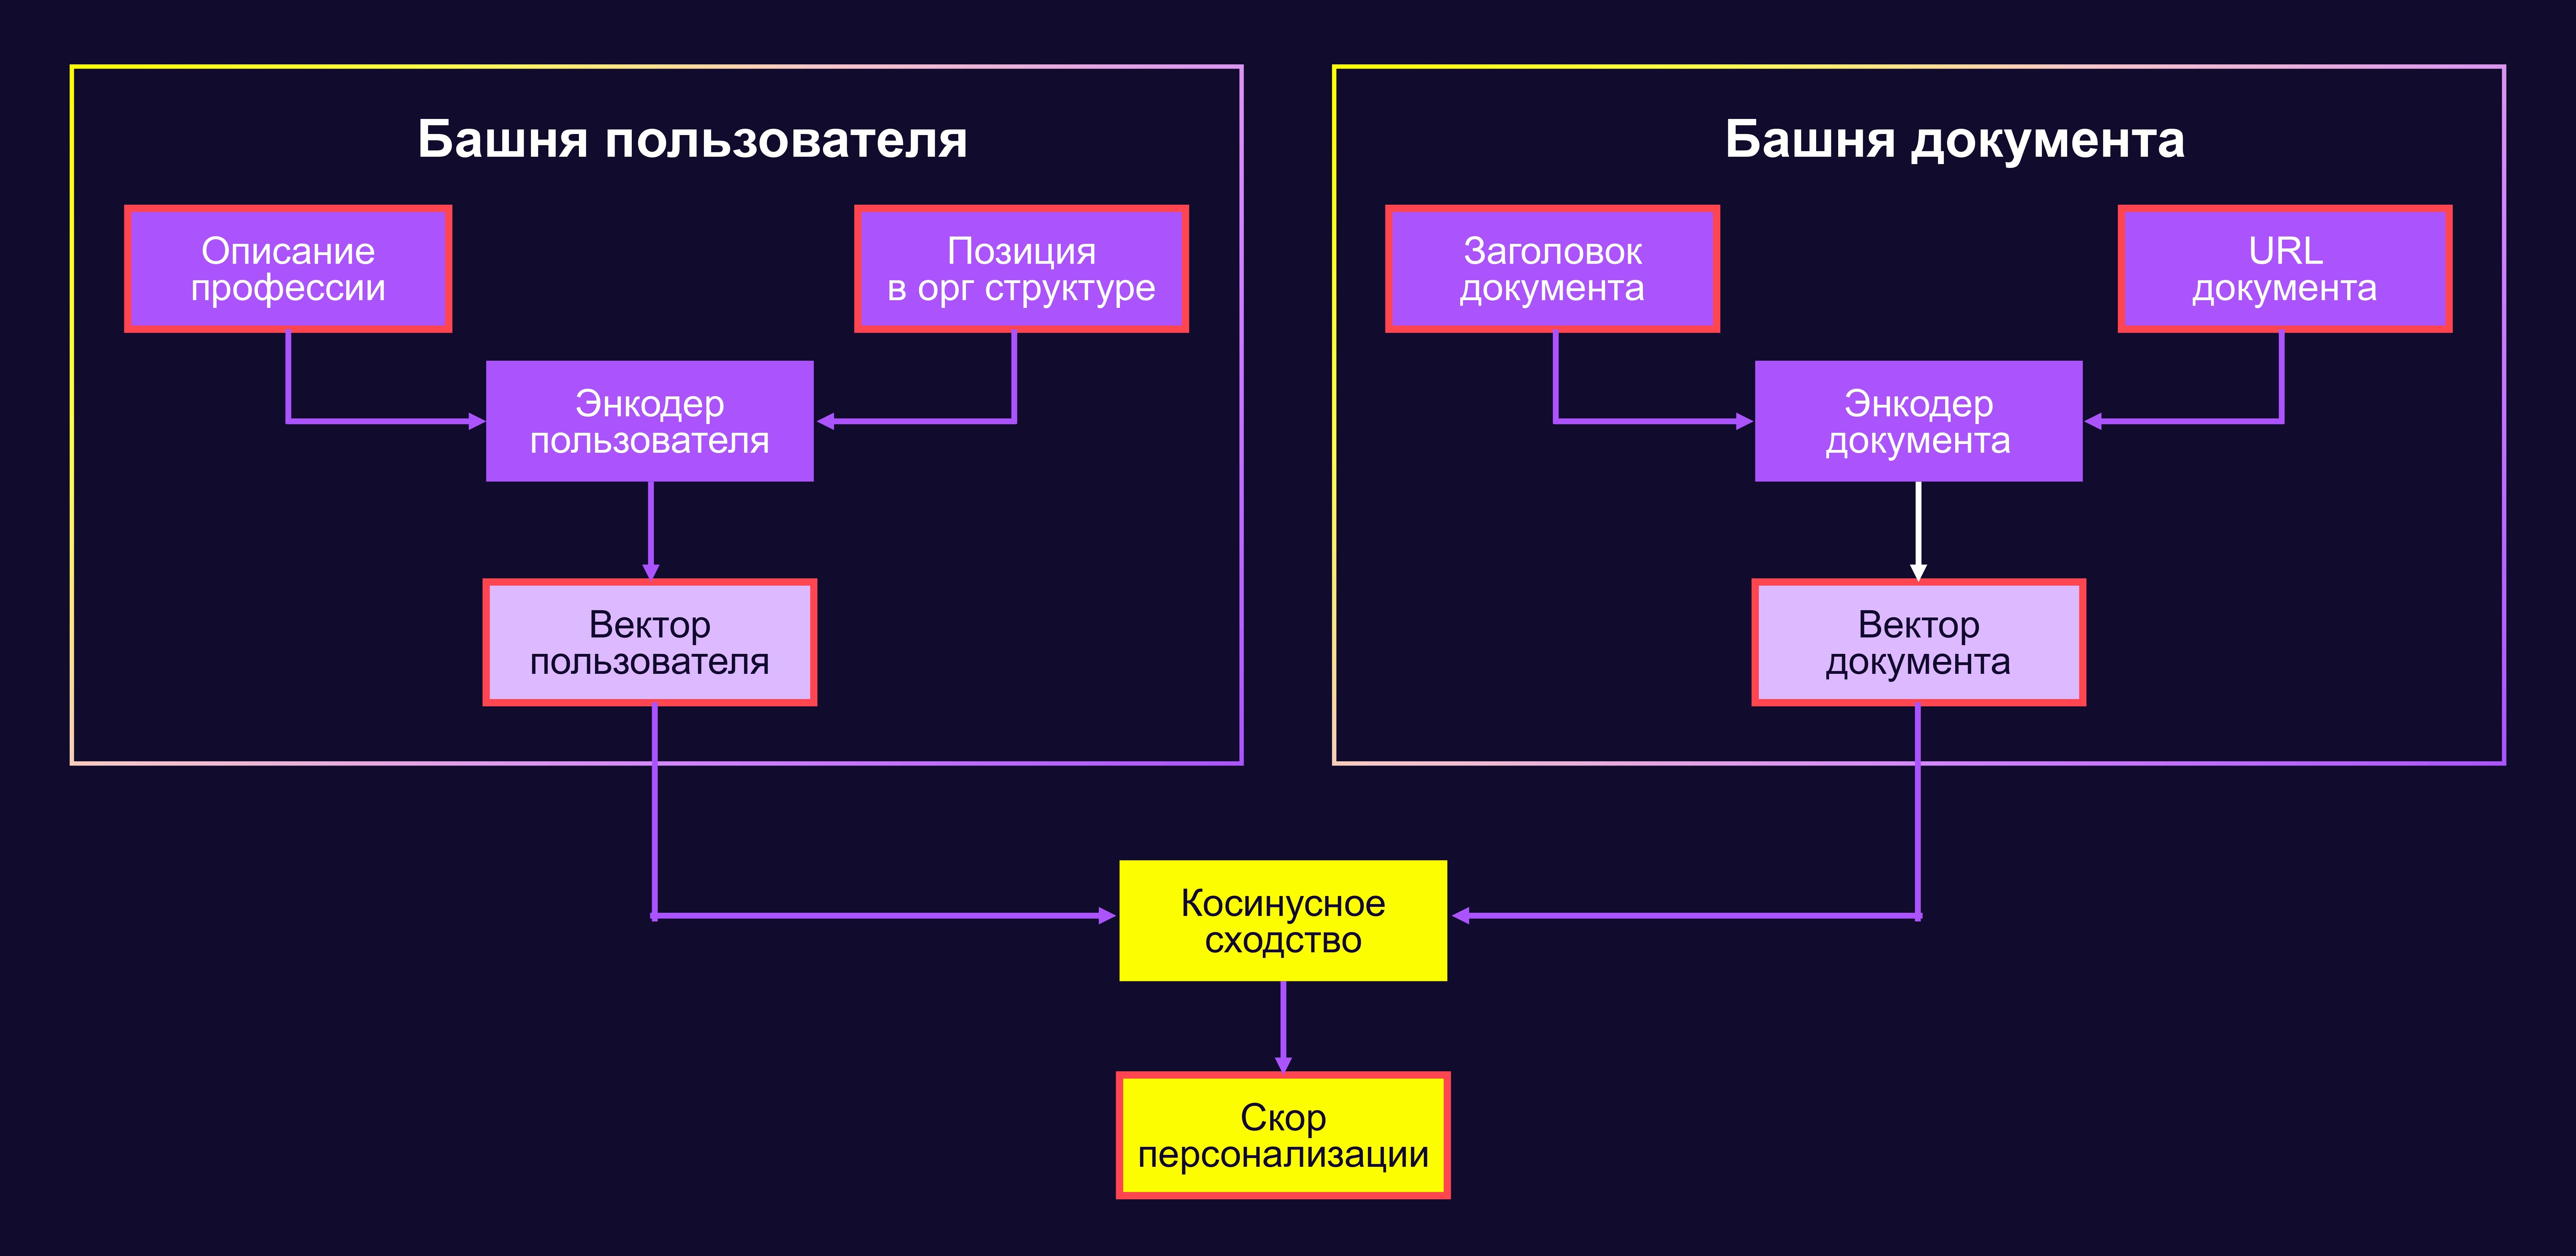
Таких эвристик у нас накопилось много, и мы решили создать единую модель, которая максимально полно характеризует пользователей, документ, и выдает скор релевантности между ними. Чтобы это сделать, мы использовали классические поисковые DSSM-модели.
DSSM состоит из двух башен — башня поискового запроса в классическом виде и башня документа:
-
В нашем случае в качестве поискового запроса выступает сам пользователь, то есть описание его положения в оргструктуре, его профессии, опыта и других характеристик. Башня генерирует его эмбеддинг (векторное представление).
-
Башня документа, используя URL страницы, title, первый параграф, генерирует эмбеддинг документа. Модель обучается тому, что эмбеды должны быть близки, если документ соответствует характеристикам пользователя.
Соответствие документа и пользователя мы проверяем на основании поисковых логов. Если пользователи из подразделения внутреннего поиска часто кликают на документацию Search and Service, значит, им эта документация интересна.
Фактически пользователи сами «размечают», какие документы полезным и актуальны для тех или иных профессий и команд. Используются все наши эвристики, сигналы, персональные статистики. Обучение на поисковых логах и логах сервисов, помогает алгоритму точнее понимать качество документа и персональный контекст.
В итоге мы получаем классический поисковый портал, в котором пользователь может ввести запрос, получить топ-10 самых релевантных документов и увидеть генеративный ответ:
Поиск на базе нескольких поисков
Возникает вопрос: поиск отдаёт топ-10 документов, а CatBoost на финальном ранжировании отдавал топ-30. Куда пропали оставшиеся 20? Они «пали в битве» за то самое сквозное ранжирование.
Дело в том, что наш поиск работает на базе нескольких поисков — по Трекеру, по Вики, по Стаффу: они физически разделены — у них разное железо, но самое главное — разная семантика. Такой разделение обусловлено историческими причинами и большими нагрузками. Например, по Трекеру есть огромная нагрузка на запись, по Стаффу — большая нагрузка на чтение.
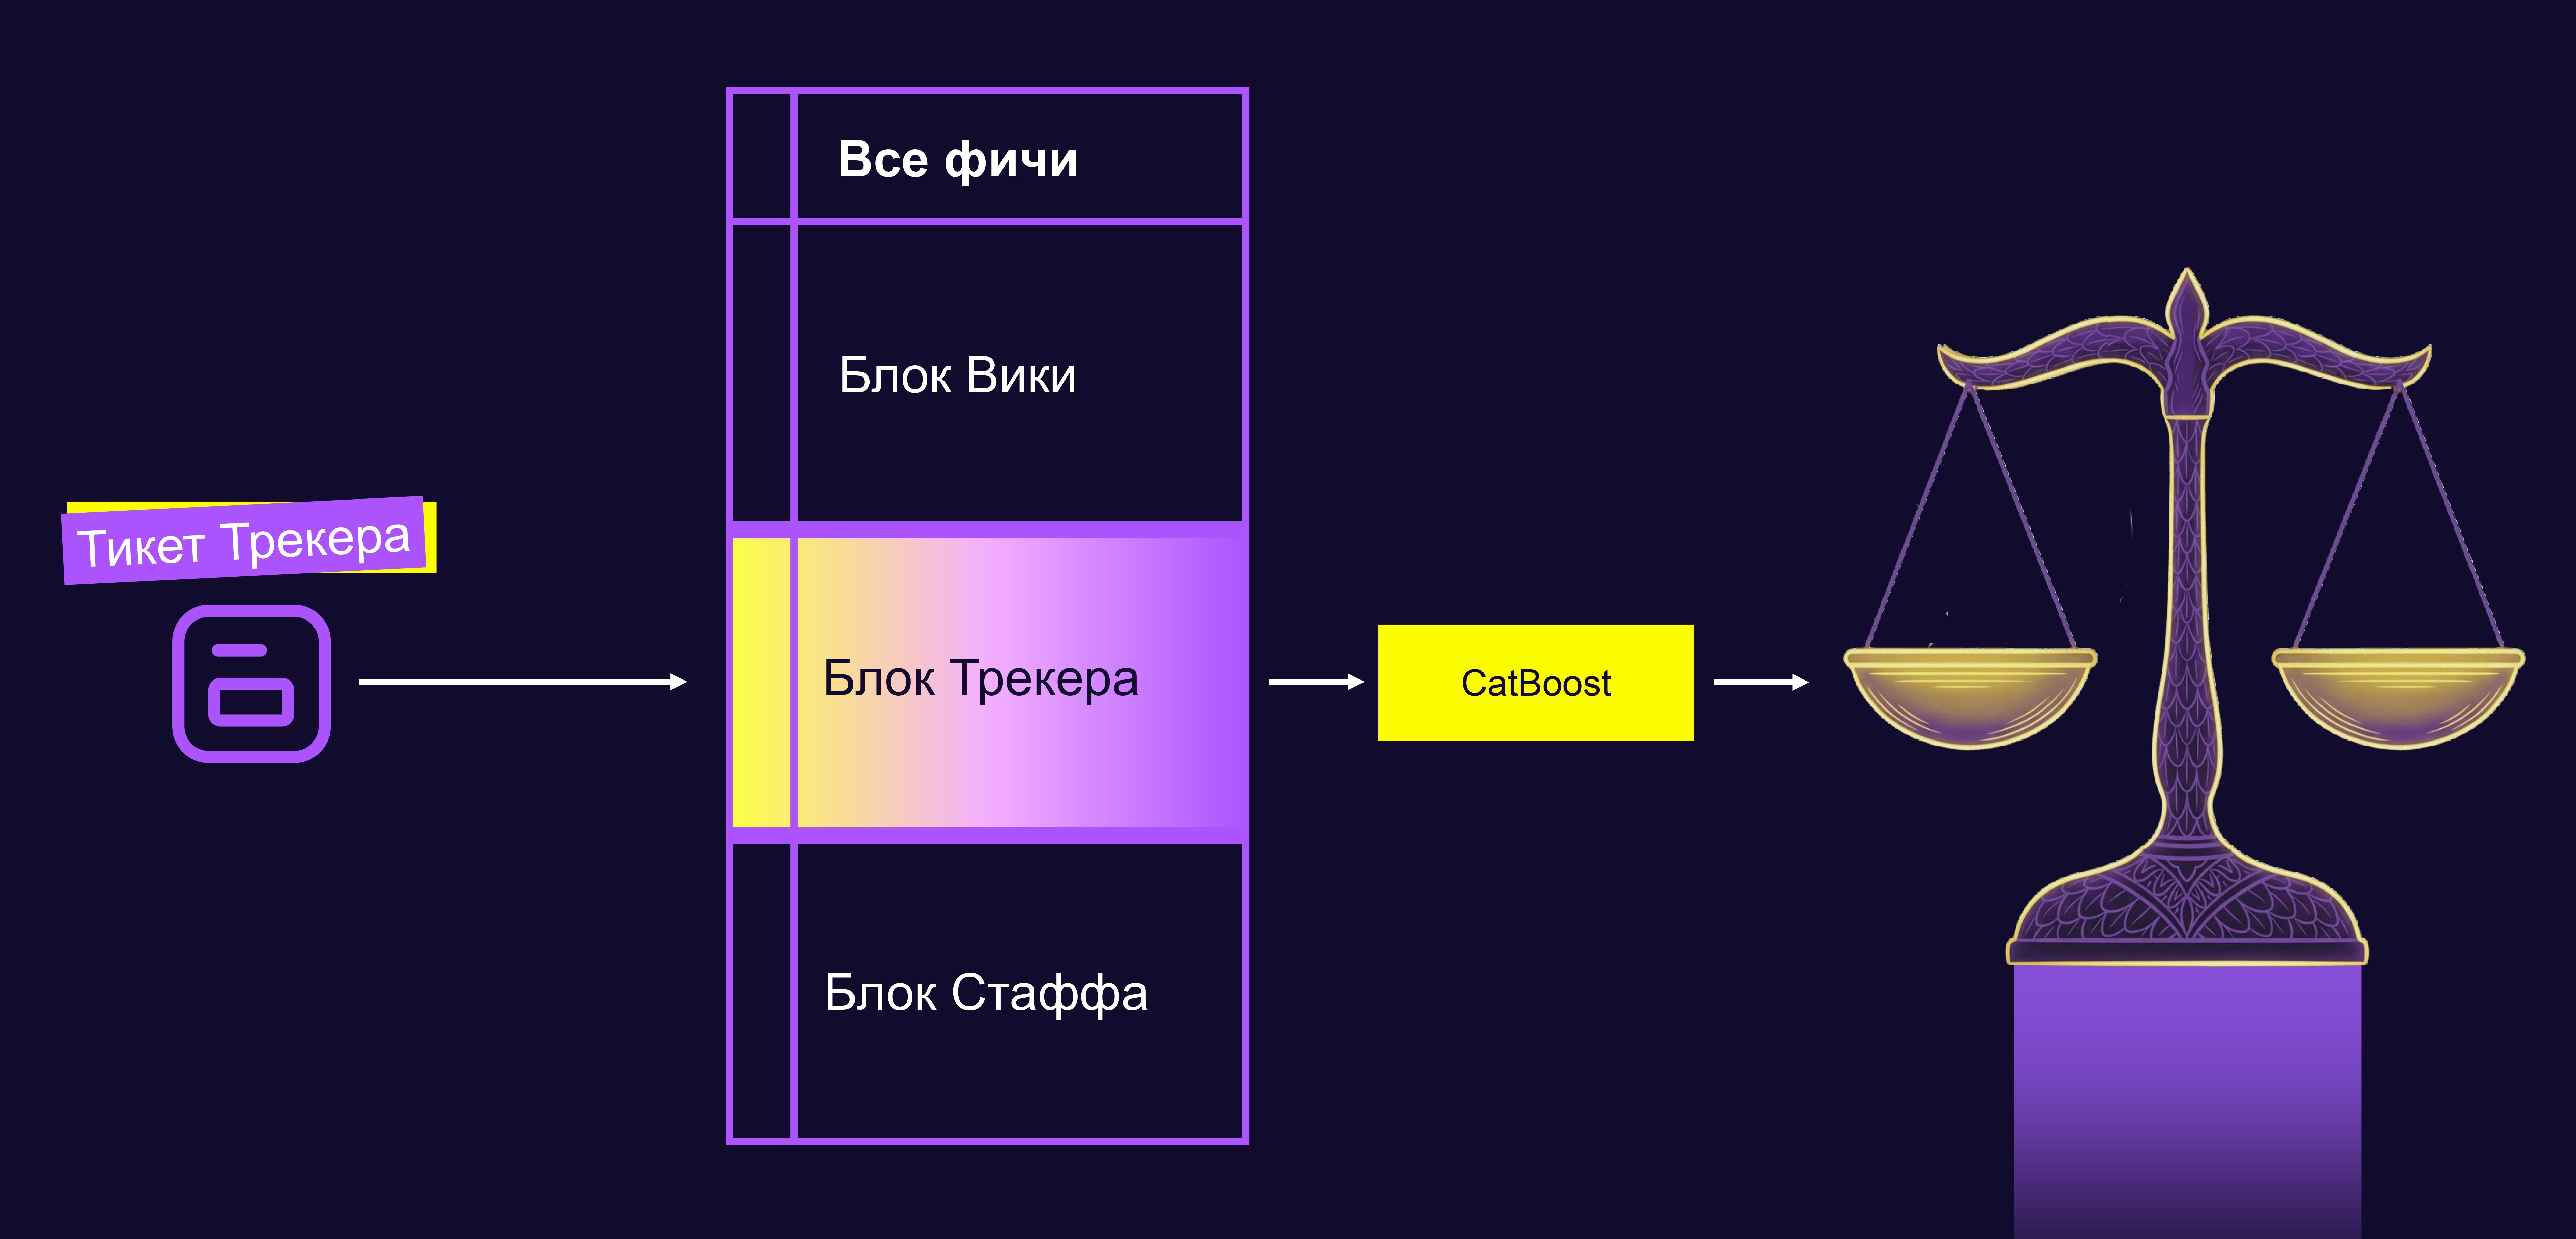
Учитывая, что мы имеем дело с разными системами, нужно придумать, как документы из них ранжировать комплексно. Берём все фичи Вики, Трекера, Стаффа, конкатенируем их в одну большую таблицу и обучаем CatBoost на пользовательских кликах.
Например, когда на ранжирование прилетает тикет Трекера, система прокрашивает только область своих соответствующих фичей. CatBoost это видит, назначает ему определённый скор.
В следующий раз, когда прилетает, документ из Вики, система прокрашивает уже другую область, но на эти общие фичи смотрит тот же CatBoost (у него тот же таргет).
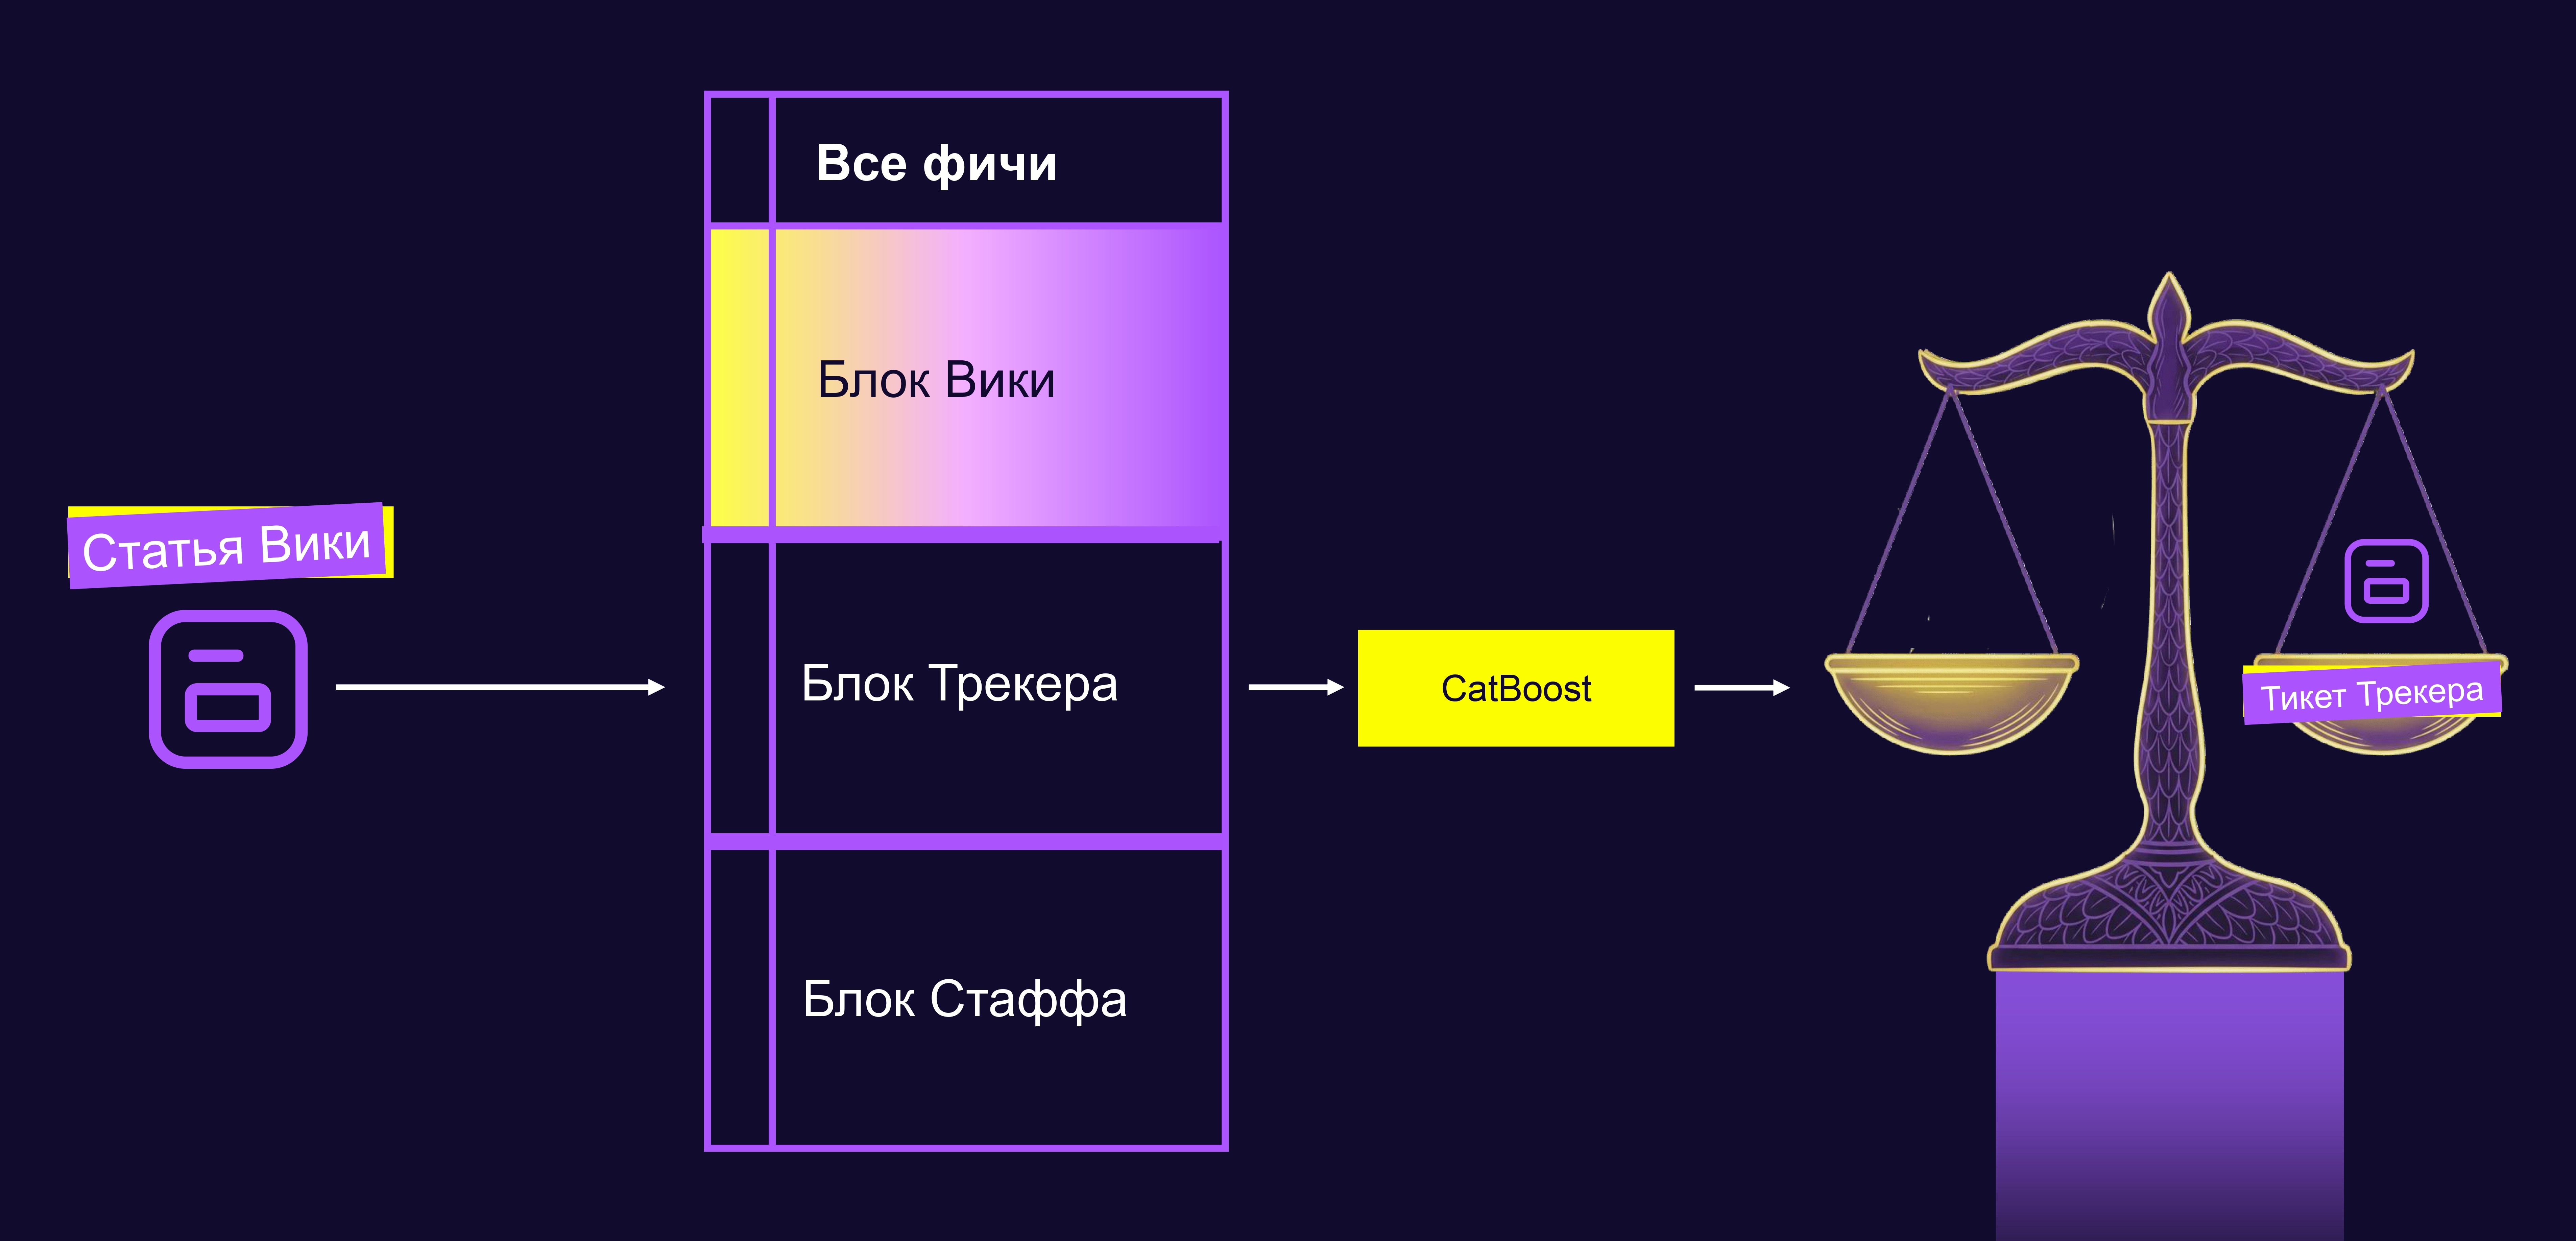
Получается, что скоры для разных документов из разных источников (несмотря на то, что у них разные фичи) становятся сопоставимыми.
Таким образом, мы получили поиск, который умеет работать с «птичьим языком», учитывает качество документов, персональный контекст, а также умеет сопоставлять и ранжировать документы из разных систем.
AI Chat: что умеет и как использует поиск
Чтобы поставить на наш мощный движок с огромным топливом красивый, модный кузов в виде генеративных ответов, нужно было понять, каков поисковый поток и что можно срезать для ускорения поиска.
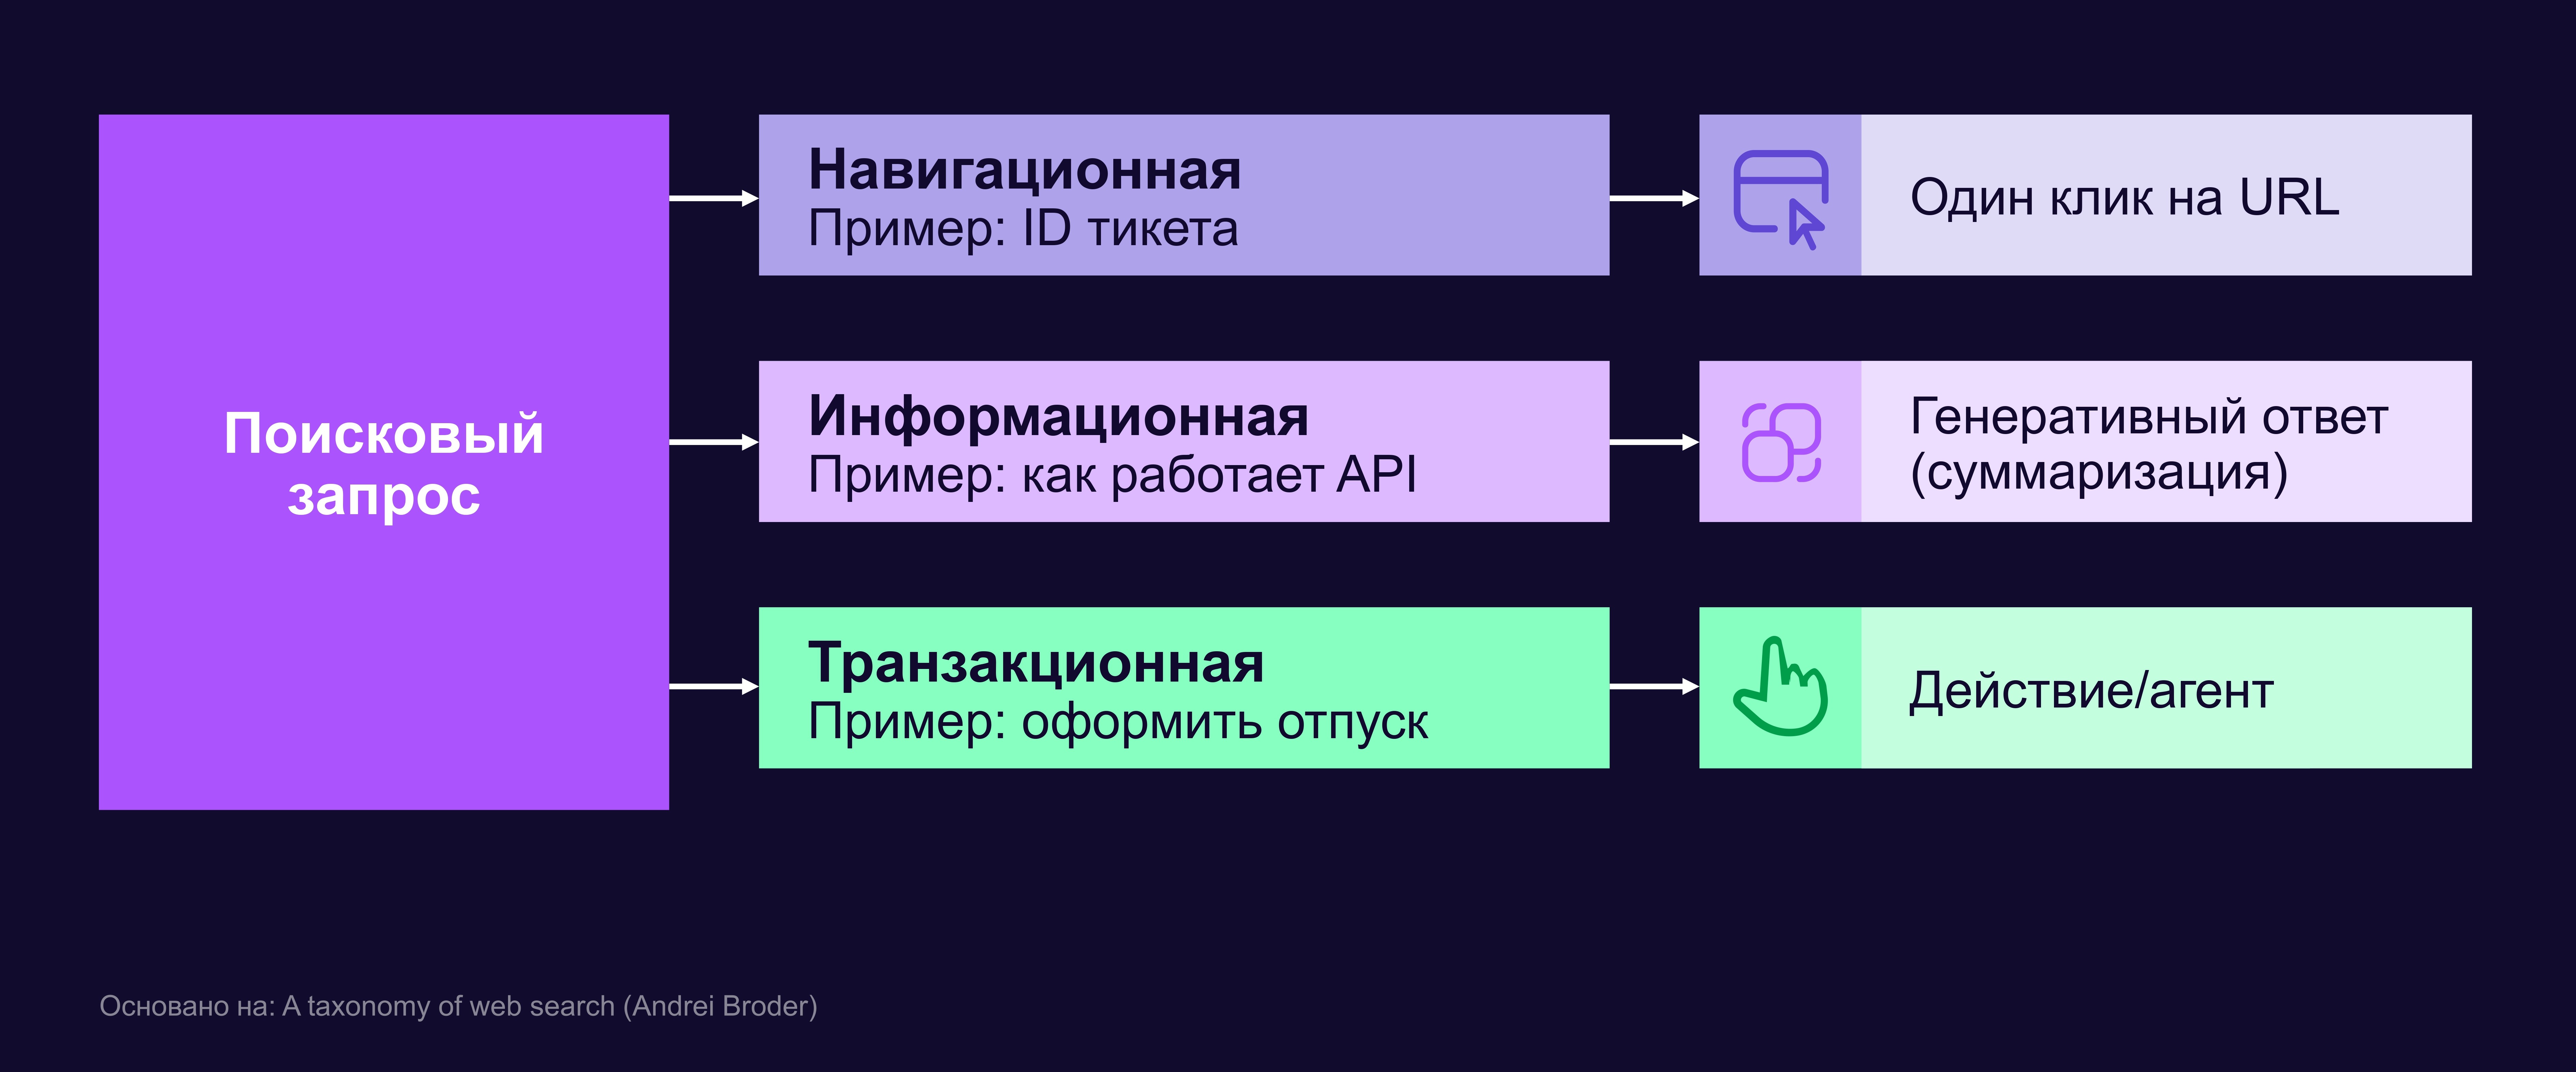
Согласно классическому исследованию A taxonomy of web search Андрея Бродера, есть три мотивации сделать запрос в поисковик:
-
Навигационная — пользователь ищет конкретную страницу. Он знает, что хочет найти, и уже работал с этим документом, просто не помнит его URL. Это, например, может быть ID тикета в Трекере или заголовок статьи на Вики. Здесь нет смысла применять LLM: они могут галлюцинировать и работают долго. В этом случае классический поиск выбивает всех конкурентов.
-
Информационная — пользователь ищет не конкретный документ, а определённые знания, ответы на свои вопросы и релевантные материалы по ним. Например, пользователь ищет «как работает api внутреннего поиска». Ему нужна именно инструкция, он может уточнять запрос, вводить разные формулировки и снова исследовать документы по теме. В этом случае уместно использовать генеративные ответы с суммаризацией, LLM и прочее.
-
Транзакционная — пользователь хочет совершить какое-то действие и для этого ищет форму или кнопку. Например, вводит запрос «оформить отпуск». Здесь подойдёт как классический поиск (он даёт ссылку на кнопку), так и агент (если кнопок много и пользователь не хочет все их нажимать, агент через MCP и IP может сделать это за него).
В интранете Яндекса мы сфокусировались на информационном сценарии и разработали самый массовый внутри компании LLM-продукт — AI Chat. Это классическая Q&A-система, в которой пользователь может задать вопрос и получить развёрнутый ответ со ссылками на источники. При этом диалог можно продолжить: уточнить информацию или задать новые вопросы, если что-то непонятно.
Поисковые фильтры
Одна из фич системы — поисковые фильтры. Наш LLM-агент базируется на поиске, а в поиск можно отправлять database-like-запросы. Например, сделать выдачу не по всему интранету, а по какому-то срезу: найти тикеты только из конкретной очереди, которую создал конкретный автор за конкретный период.
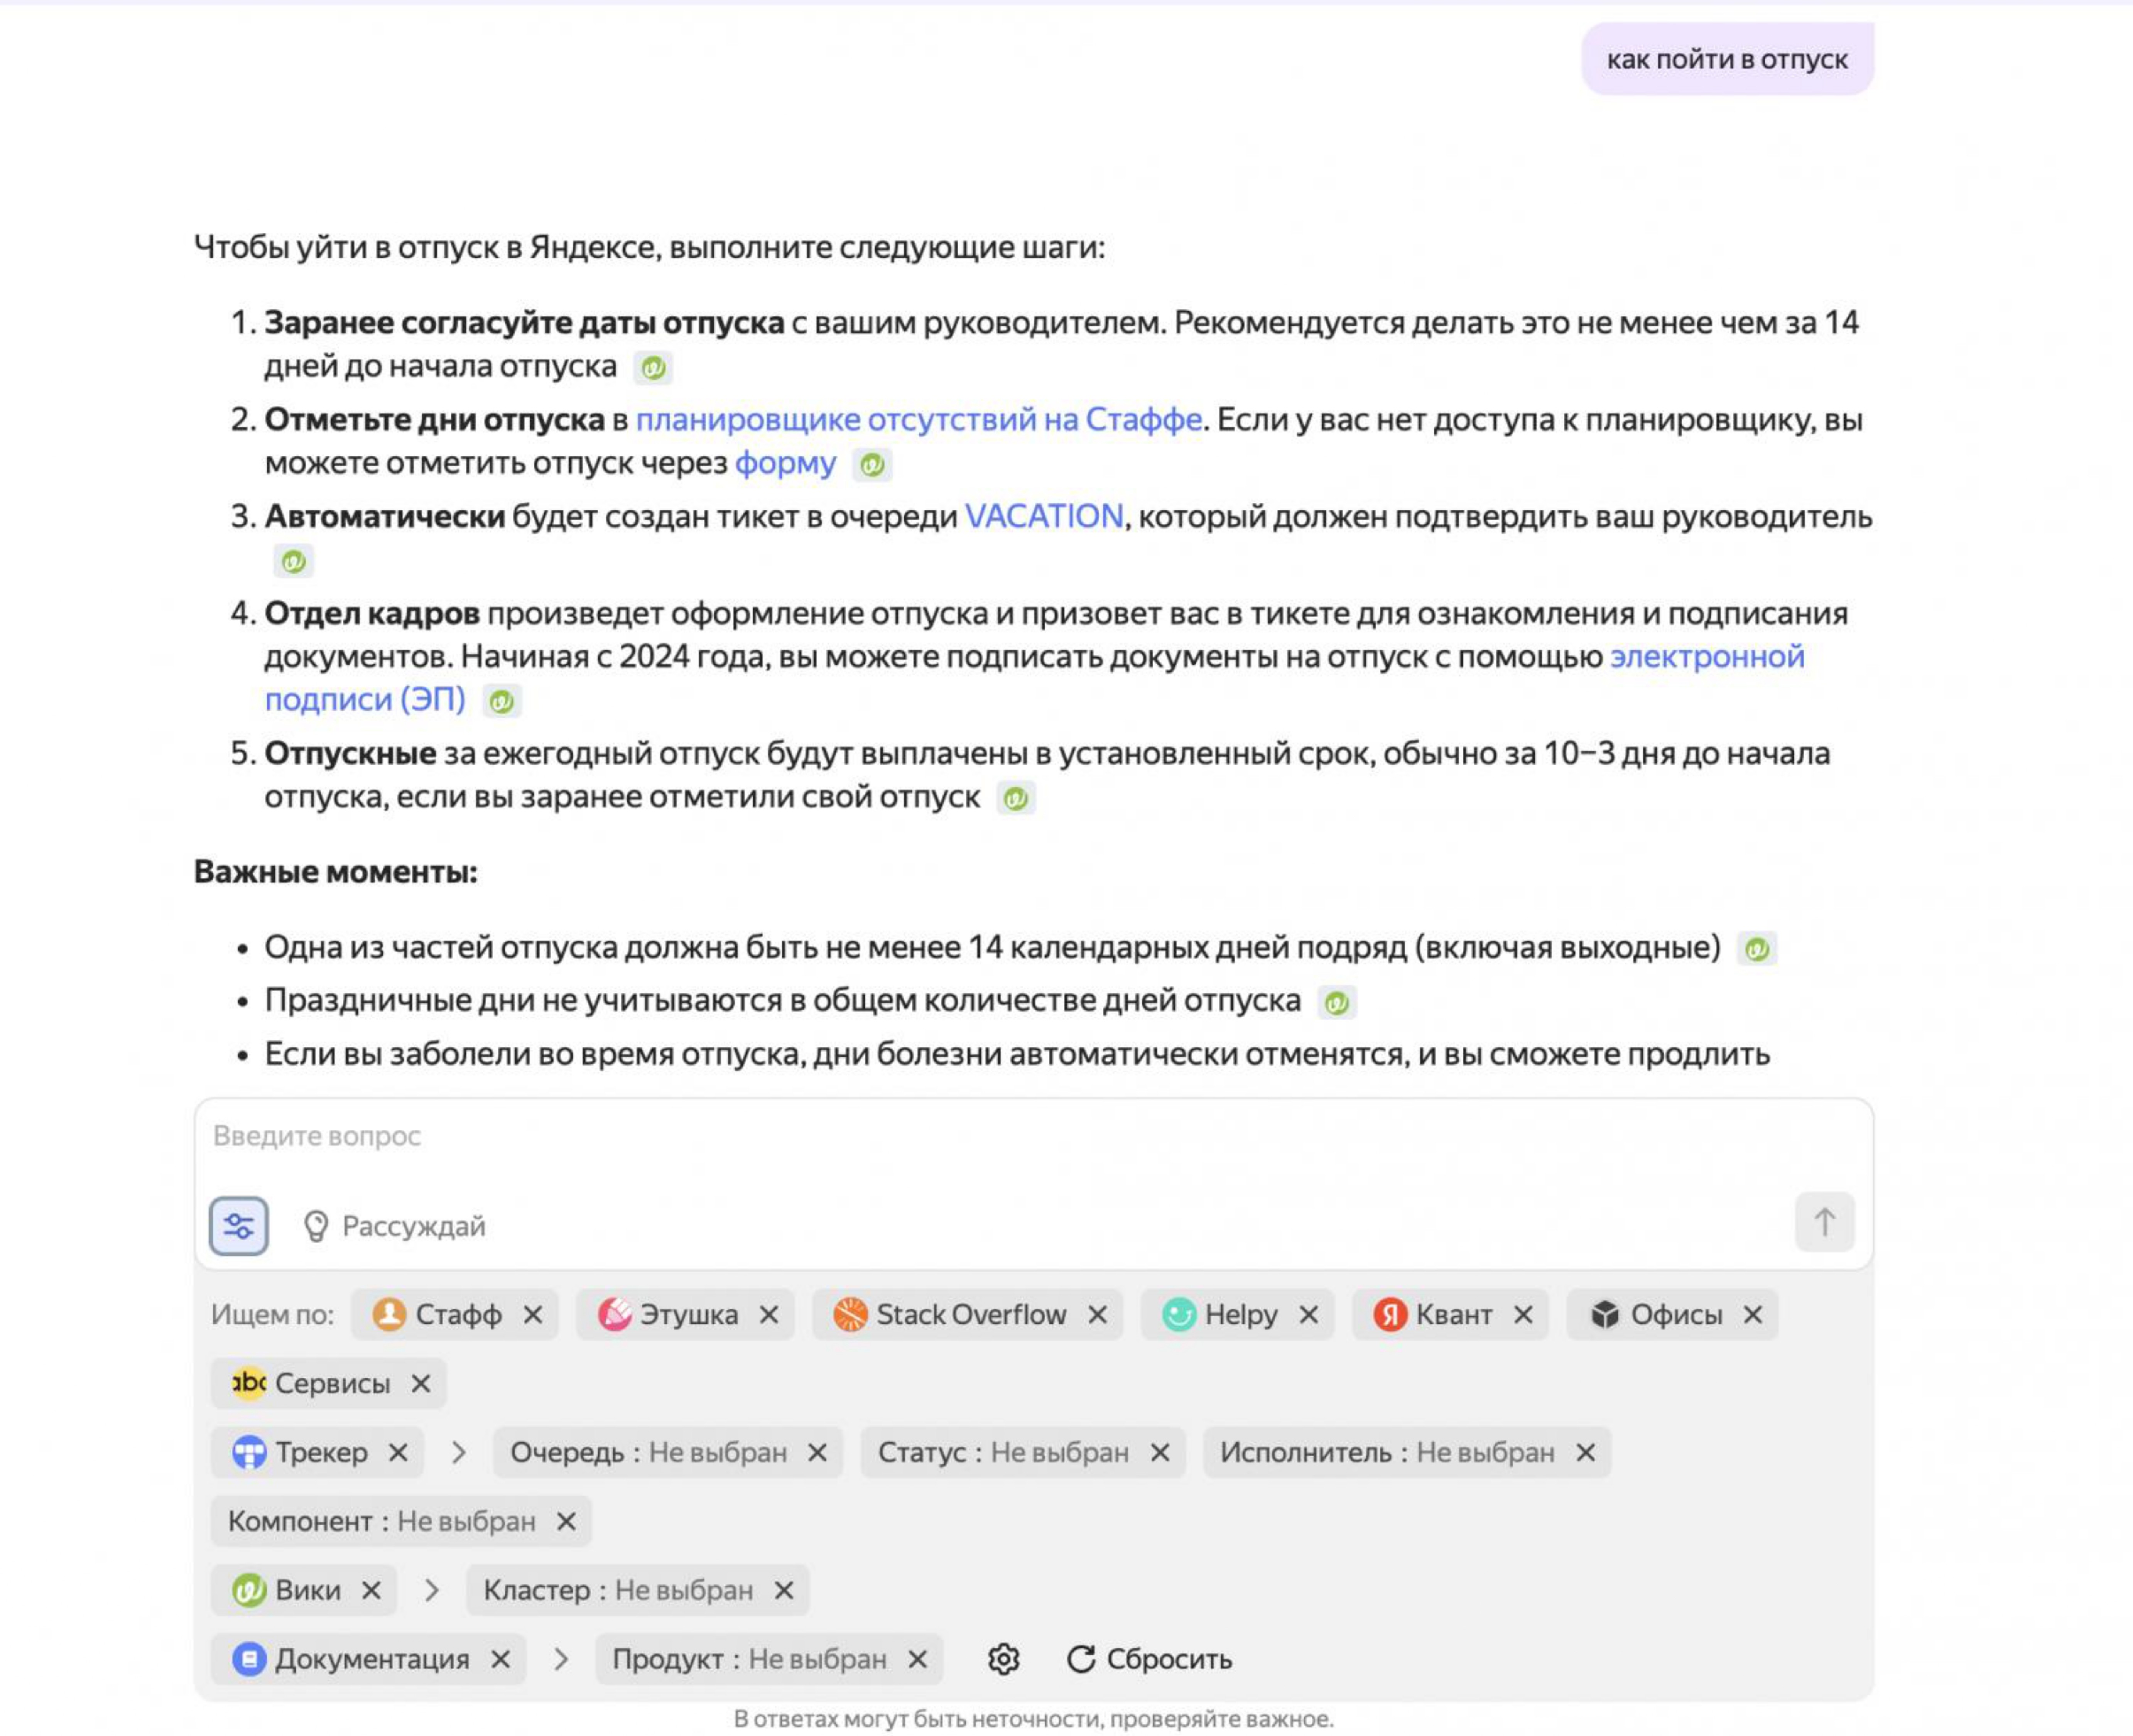
В чём плюсы? Допустим, коллеги из внутреннего сервиса разработали новую админку и хотят срезать поток однотипных запросов от пользователей в саппорт. Они пишут подробную документацию про свой сервис, но обычно этого недостаточно: людям лень искать документацию и читать инструкции.
Чтобы решить проблему, сервис подключает наш AI Chat. Теперь, если у пользователя возникает проблема в админке, он нажимает на волшебную палочку и получает генеративный ответ. Админы могут настроить фильтры — ограничить поиск по конкретной документации.
Так, в примере ниже поиск ограничен по YDB:
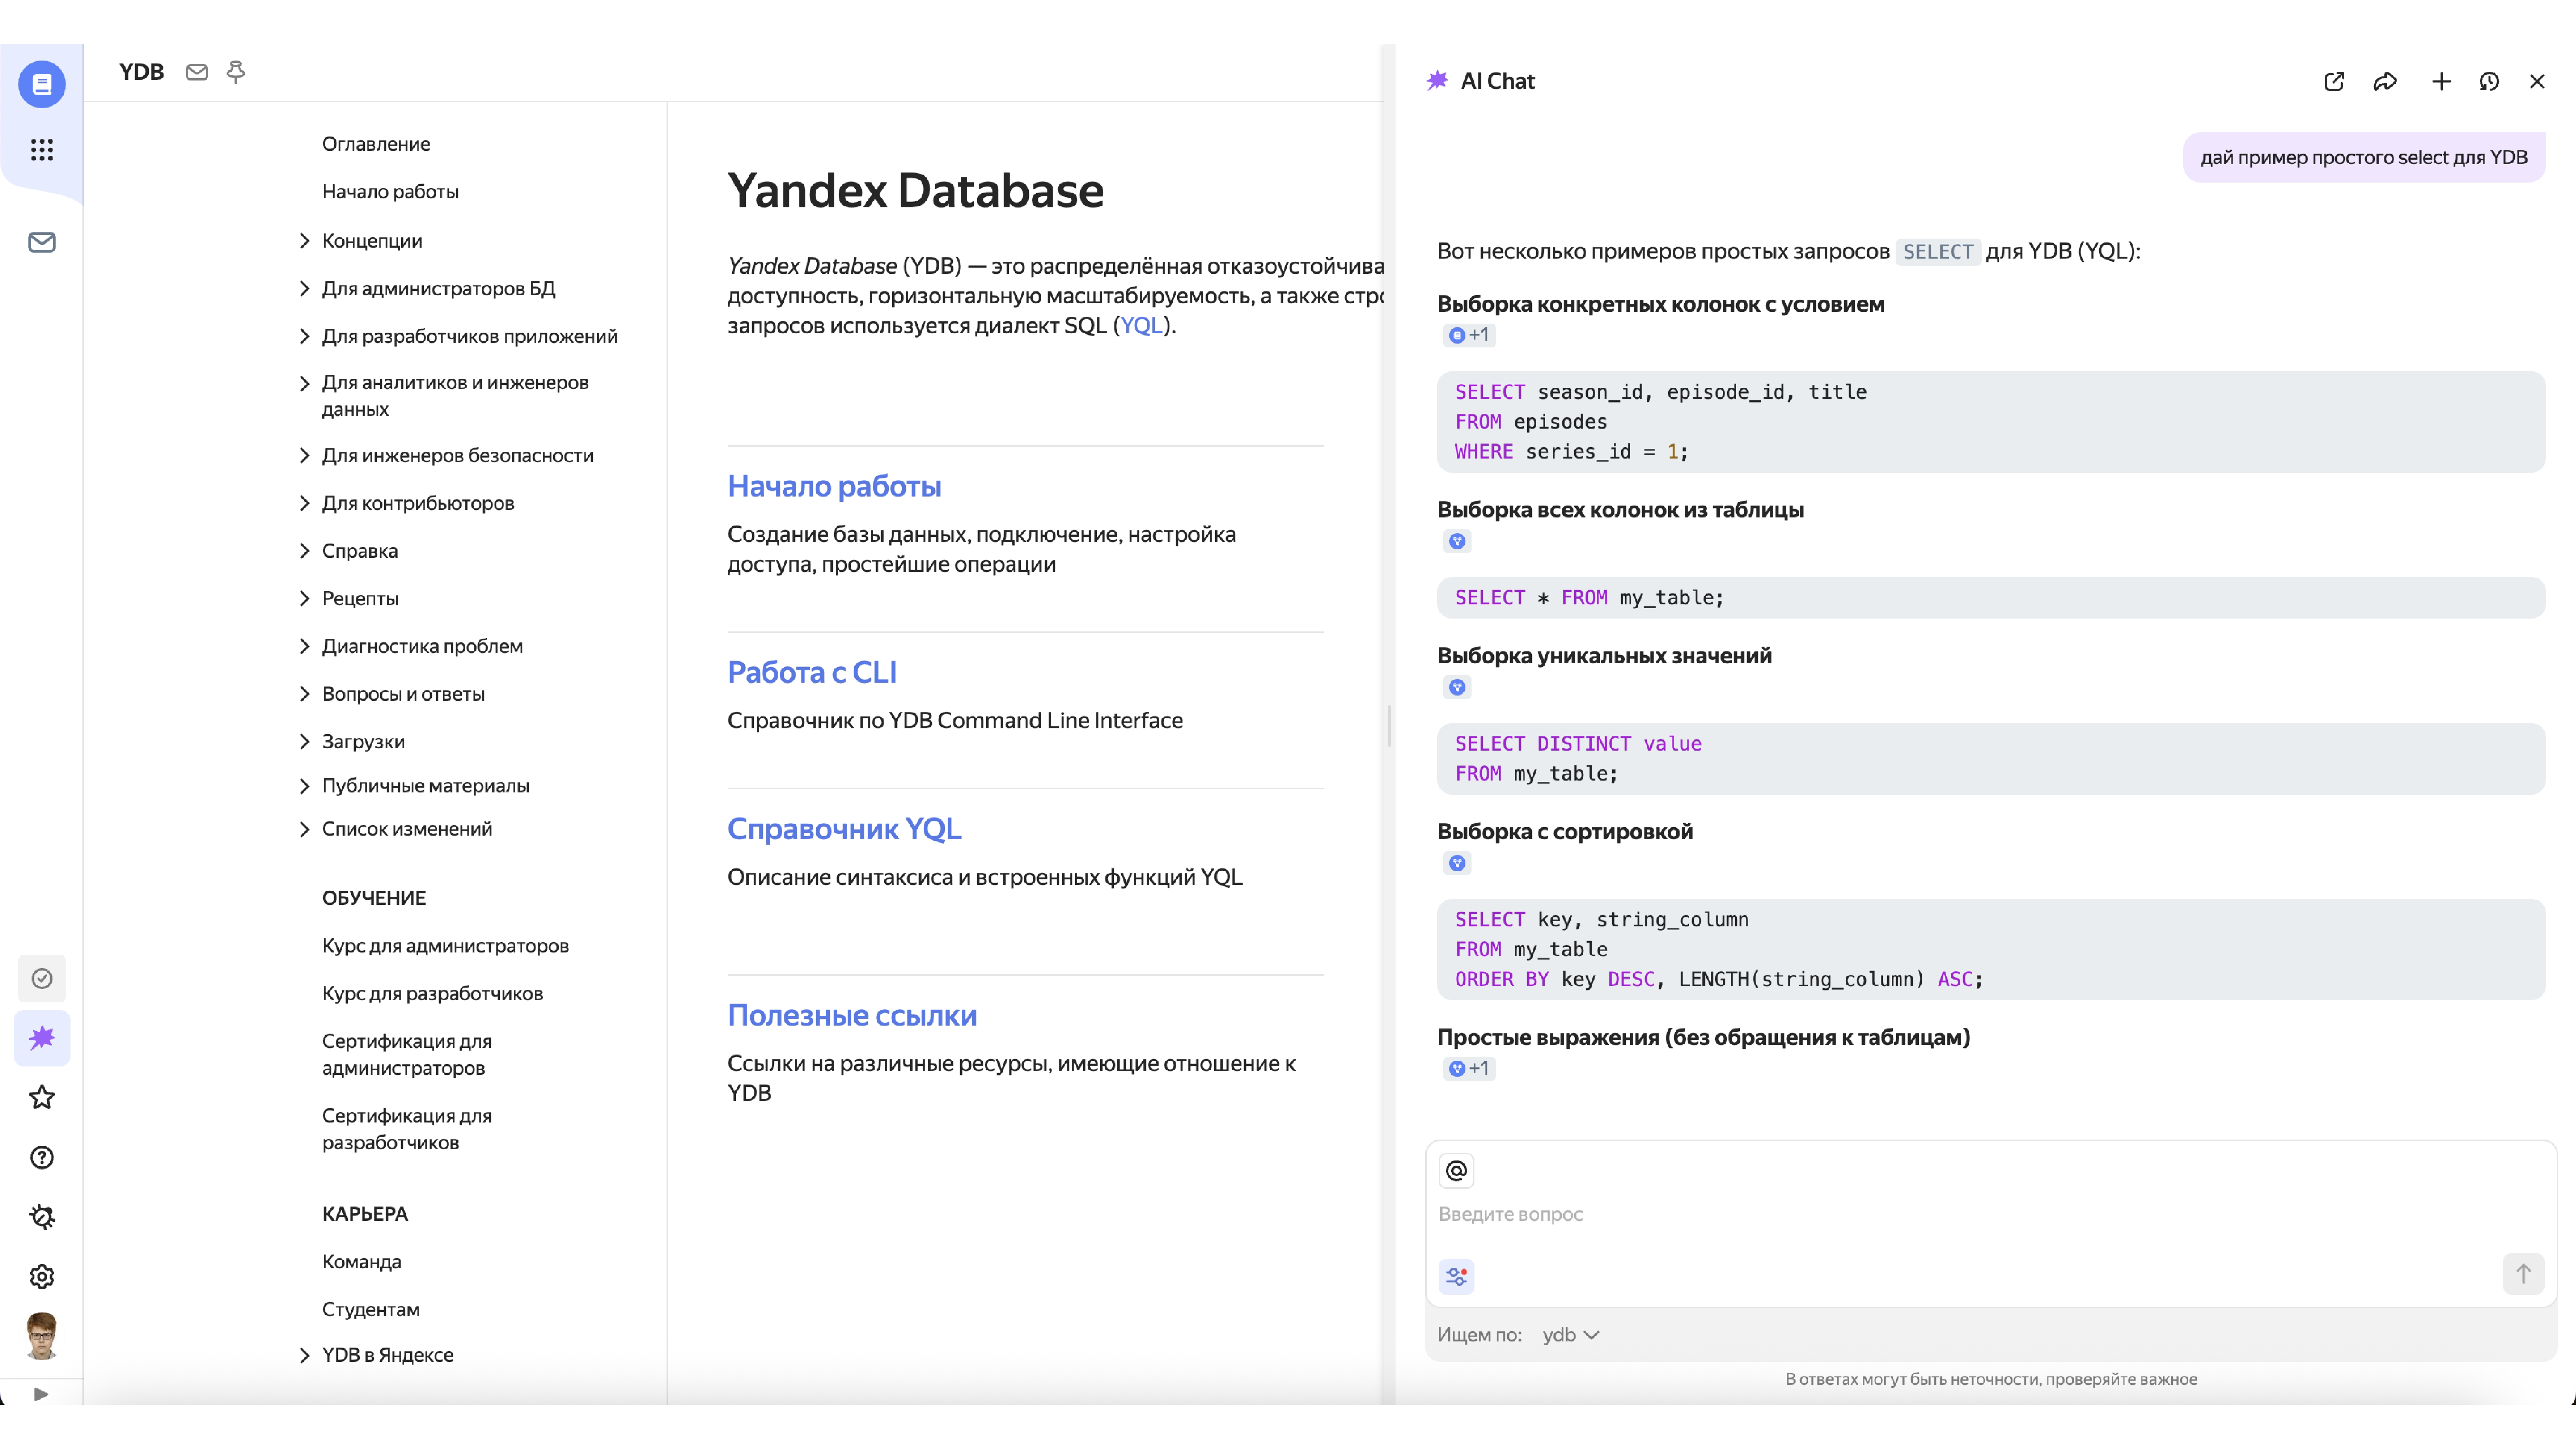
Если попросить AI Chat написать простой SQL-запрос к базе, он не будет писать SQL для PostgreSQL или Clickhouse, а напишет YQL, который подходит для YDB.
Когда сотрудники видят такой продуманный поиск, у них появляется мотивация писать документацию: она приносит реальную пользу, а люди задают вопросы не саппорту, отвлекая команду, а в AI Chat. Это экономит время всем.
Метрики внедрений
Какие внедрения во внутренний поиск дали самые большие метрики? И как-то, что мы делаем в интранете, влияет на всю компанию?
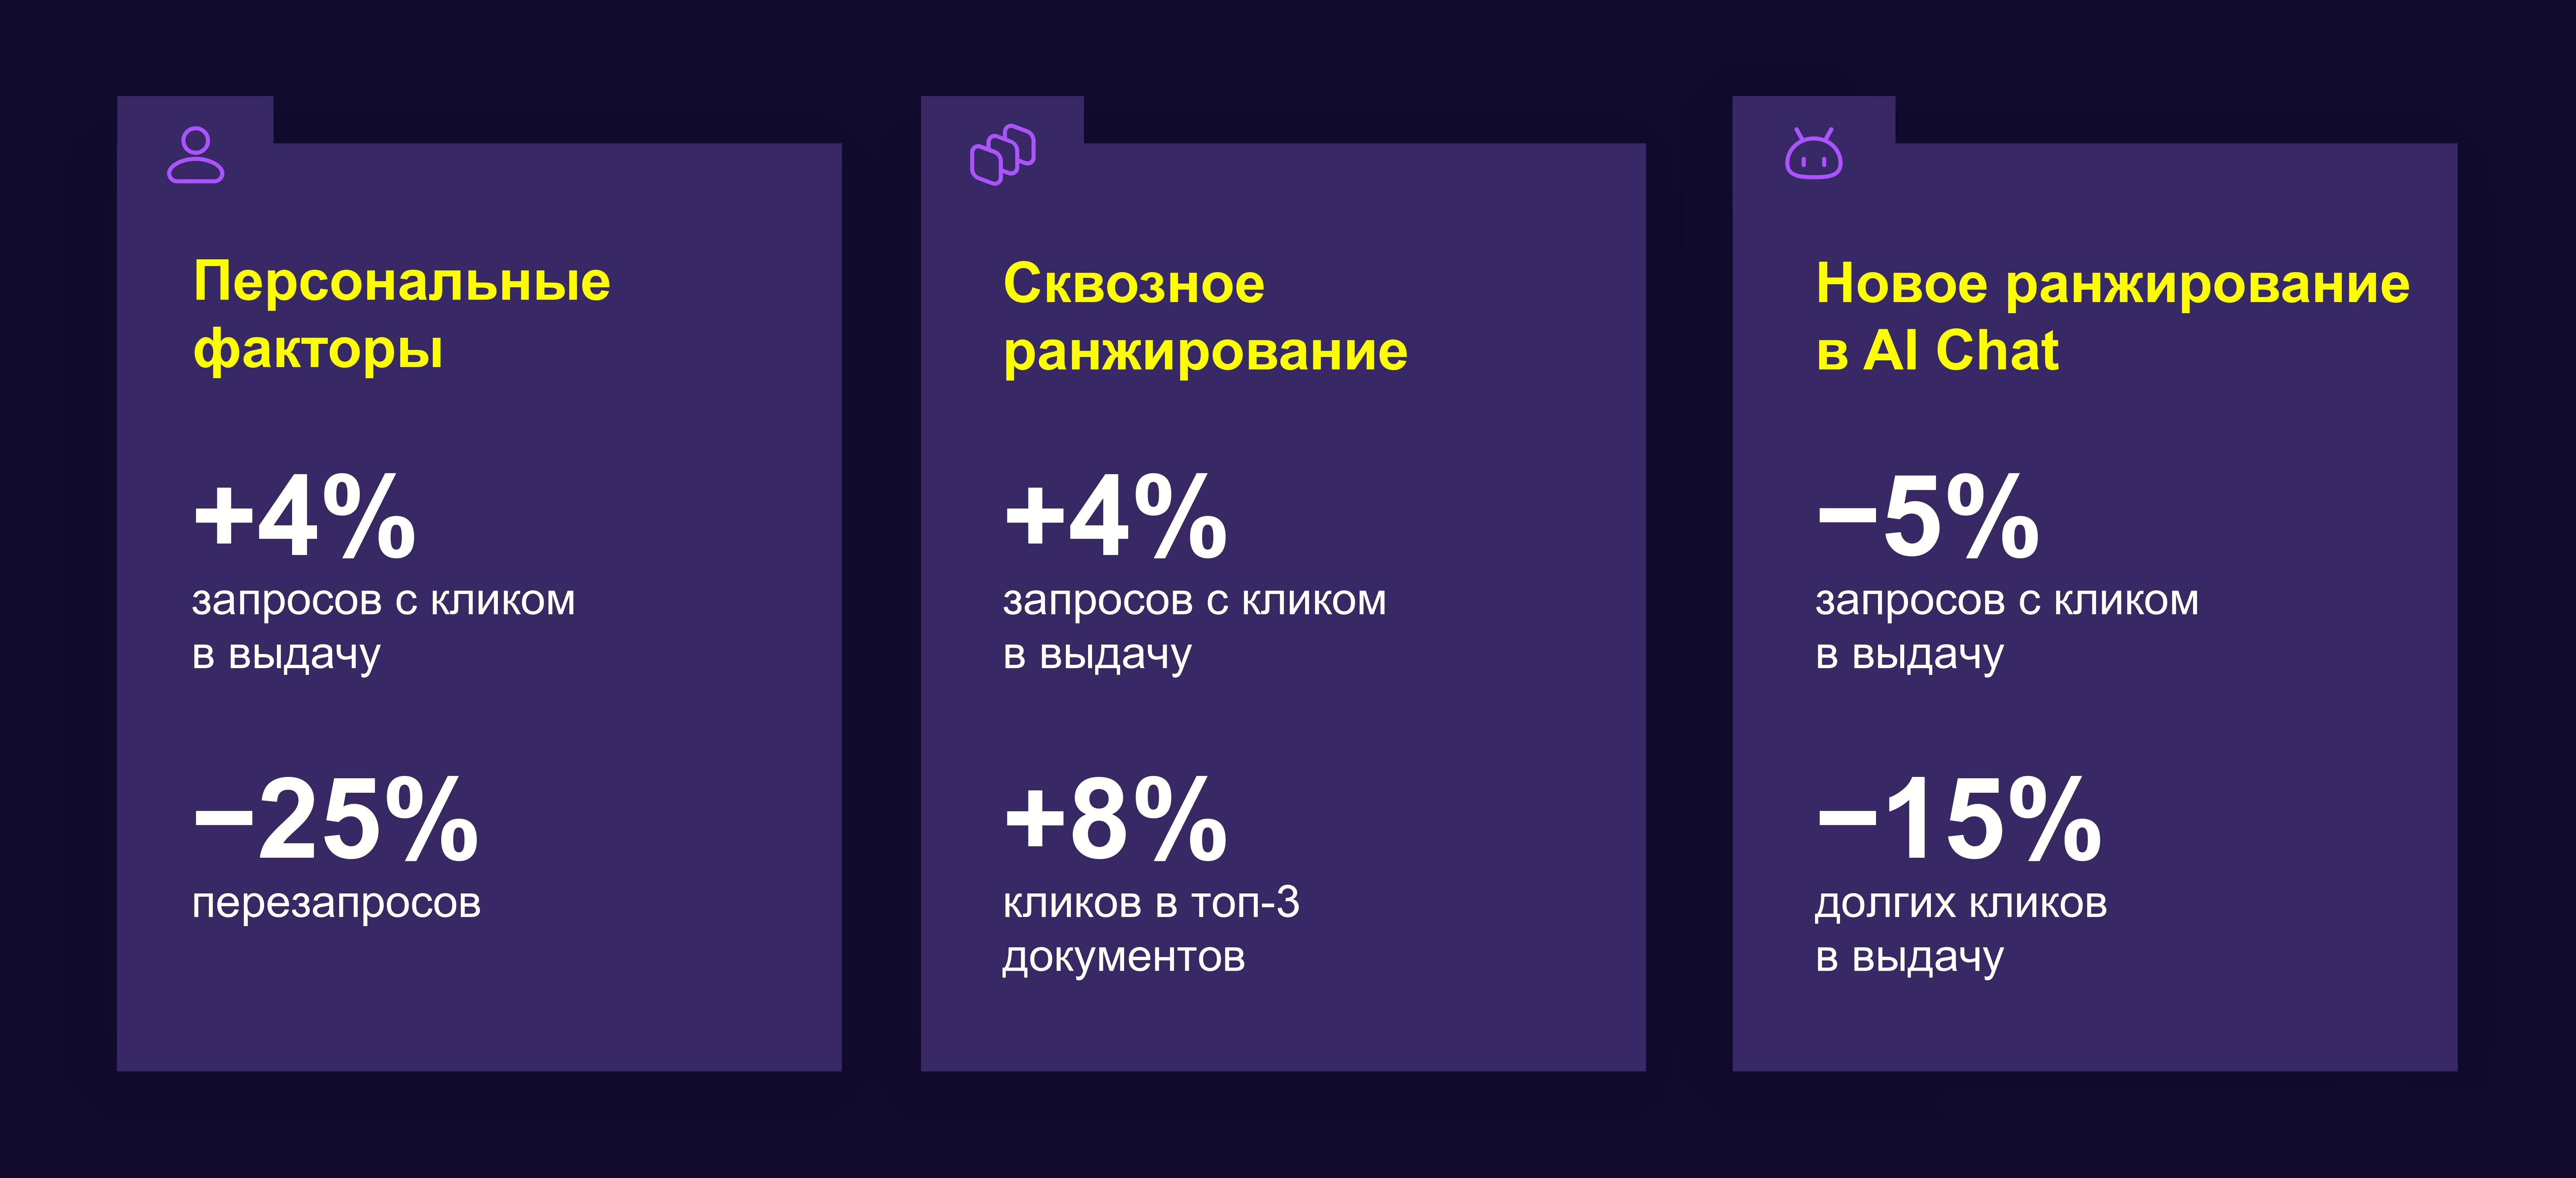
Вот метрики по трём крупным внедрениям за последние несколько лет:
-
Внедрение персональных факторов — персонализация ранжирования. Это самый персональный DSSM и пачка эвристик, которые подсказывают, насколько данный документ подходит пользователю. Внедрение дало +4% запросов с кликом в выдачу (люди стали чаще кликать выдачу). Числа могут показаться маленькими, но, учитывая масштаб внутреннего поиска, цифры — огромные. Они отражают ощутимые для пользователей изменения.
Также важно, что на 25% упало количество перезапросов — это когда пользователь пытается объяснить поиску, что он на самом деле ищет.
-
Внедрение сквозного ранжирования между Трекером, Вики, Стаффом и другими системами. Оно дало такой же эффект по росту обращений в поиск и увеличило точность поиска (на 8% больше стали кликать в топ-3).
-
Новое ранжирование в AI Chat — благодаря персонализации, объединению поиска по нескольким источникам, мы получили −5% запросов с кликом в выдачу и −15% долгих кликов в выдачу (когда пользователь просматривал документ больше 5 минут). Чем лучше поиск, тем выше качество генеративных ответов. Пользователи готовы отказаться от привычного способа потребления информации в пользу более продвинутых LLM-технологий. Но это происходит только тогда, когда эти технологии действительно работают.
В масштабе всего Яндекса наша система AI Chat+Поиск по интранету даёт следующие метрики:
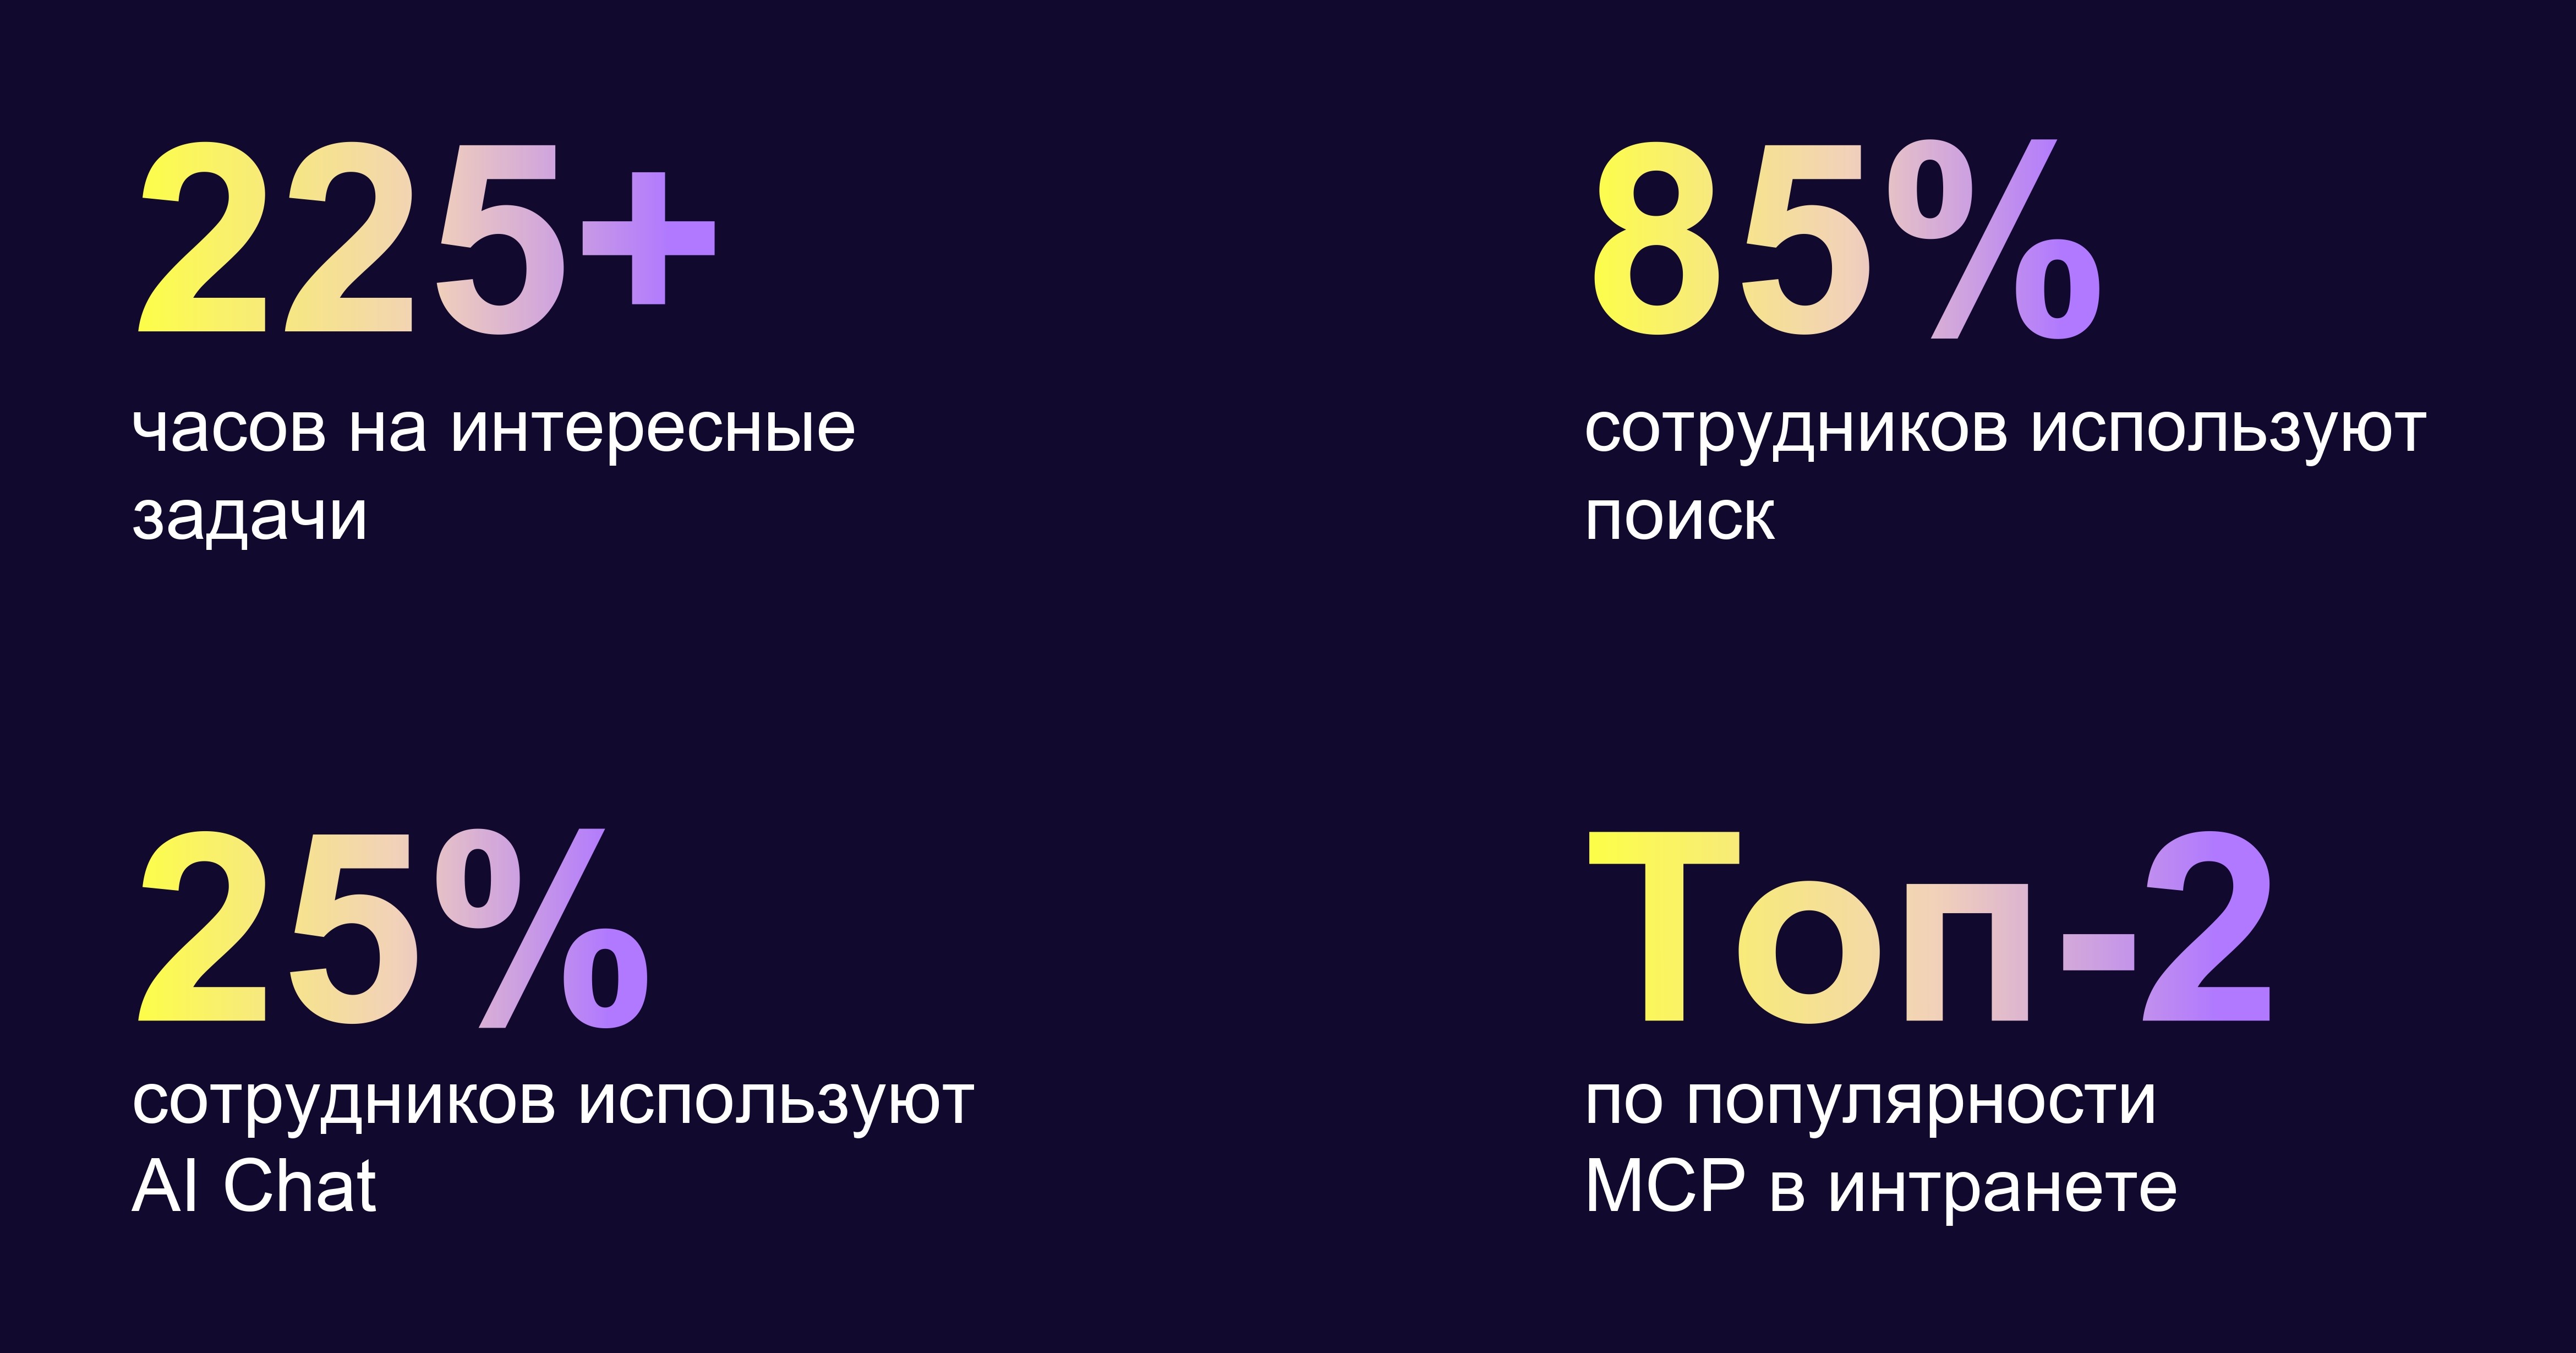
Таким образом, 85% всех сотрудников Яндекса обращаются ко внутреннему поиску — это 100% сотрудников, у которых есть к нему доступ. 25% сотрудников используют генеративный ответ, и он экономит им свыше 320 часов рабочего времени на более интересные задачи. Интересно, что внутренний поиск, генеративный ответ предпочитают не только люди, но и агенты: мы топ-2 популярности MCP в контуре Яндекса.
Какие выводы можно сделать для развития ML-инфраструктуры корпоративных знаний?
-
Главная ценность — знания
Основа работы генеративных, поисковых и прочих технологий — это знание и культура работы с документацией. Если у организации нет документации, то генеративному ответу и поиску не из чего отвечать. -
Логи и аналитика — основа качества
Чтобы документация превратилась в полезную для поиска и агентов информацию, нужна качественная инфраструктура, которая позволяет обучать модели и применять знания на практике. -
У ML есть специализация
LLM плохо работает с большими массивами чисел, ей трудно объяснить правила ранжирования. Гораздо легче скинуть это на специализированный алгоритм вроде CatBoost, который хорошо работает с таким объёмом чисел и может поддержать LLM, чтобы она отвечала более качественно. -
LLM — интерфейс над инфраструктурой знаний
У LLM может быть много специализаций: она может реформулировать запросы, помогать формировать карточки ответов, но самое крутое — это суммаризация знаний. LLM — это не основа для ML-технологий компании, а именно интерфейс к базе знаний в уже существующей инфраструктуре, которая позволяет быстрее отвечать на вопросы пользователей.
LLM-инструменты — реальный способ ускорить работу с документами и обмен знаниями, а это измеримая польза для компании и команд.
Сейчас внутренний поиск активно растёт, мы тестируем разные гипотезы, делаем A/B-тесты, занимаемся LLM в ранжировании и новыми полезными фичами.
ML Laboratory — часть команды Yandex Platform Engineering: мы помогаем сервисам Яндекса развивать и внедрять ML-решения, выстраивая весь пайплайн — от сбора данных и метрик до написания продакшен-инфраструктуры.